Vektor Datenbanken einfach erklärt
Vektor-Datenbanken gehören zu den wichtigsten Bausteinen moderner KI-Systeme. Wer heute über Large Language Models, semantische Suche, RAG oder intelligente Chatbots spricht, kommt an diesem Thema kaum vorbei.
Architektur, Funktionsweise und Bedeutung
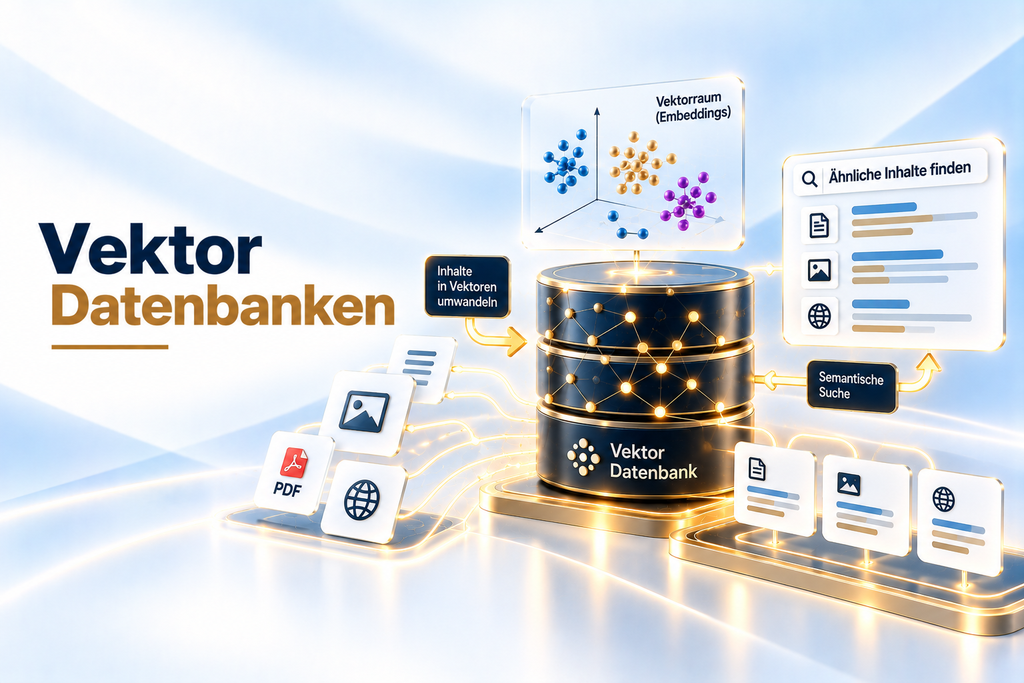
Vektordatenbanken gehören zu den wichtigsten Technologien für moderne KI-Suchsysteme. Sie ermöglichen es, Texte, Bilder und andere Informationen anhand mathematischer Ähnlichkeiten zu durchsuchen, statt ausschließlich nach identischen Wörtern oder festen Datenbankwerten zu suchen.
Damit bilden sie eine wichtige Grundlage für semantische Suche, intelligente Dokumentenverwaltung, Produktempfehlungen und viele Anwendungen mit Retrieval-Augmented Generation (RAG).
Ein KI-Assistent kann beispielsweise eine Frage beantworten, obwohl die passenden Informationen in einer Wissensdatenbank völlig anders formuliert sind.
Die eigentliche Bedeutung wird dabei nicht von der Datenbank selbst verstanden. Stattdessen verwendet das System sogenannte Embeddings: numerische Darstellungen, die von trainierten KI-Modellen erzeugt werden.
Moderne Vektordatenbanken kombinieren solche Darstellungen mit leistungsfähigen Suchverfahren wie HNSW, Approximate Nearest Neighbor Search, Hybrid Search und Re-Ranking.
Auch klassische Datenbanksysteme haben sich weiterentwickelt. Mit Erweiterungen wie pgvector kann beispielsweise PostgreSQL selbst für die Suche nach ähnlichen Vektoren verwendet werden.
Doch was genau ist eine Vektordatenbank? Wie funktioniert die Ähnlichkeitssuche? Welche Unterschiede bestehen zwischen pgvector, Qdrant, Weaviate und anderen Lösungen? Und wann lohnt sich eine Vektordatenbank für eine Website oder ein Unternehmen?
Dieser Ratgeber erklärt die technischen Grundlagen verständlich, stellt wichtige Suchverfahren vor und zeigt, worauf es bei der Auswahl und sicheren Nutzung ankommt.
Was ist eine Vektordatenbank?
Eine Vektordatenbank ist ein Datenbanksystem beziehungsweise eine Datenbankfunktion, die numerische Vektoren speichern, verwalten und anhand mathematischer Ähnlichkeit durchsuchen kann.
Solche Vektoren können beispielsweise Texte, Bilder, Audioaufnahmen oder andere Inhalte repräsentieren.
Die mathematischen Darstellungen werden häufig durch spezielle KI-Modelle erzeugt.
Ein Beispiel:
Ein Nutzer sucht nach einer „günstigen Unterkunft mit Schwimmbad“.
Eine vorhandene Beschreibung lautet:
„Preiswertes Ferienapartment mit Zugang zum Gemeinschaftspool.“
Eine klassische Suche nach exakt passenden Wörtern könnte Schwierigkeiten haben, beide Formulierungen miteinander zu verbinden.
Ein geeignetes Embedding-Modell kann dagegen ähnliche semantische Merkmale erfassen.
Eine Vektordatenbank sucht anschließend nach mathematisch ähnlichen Repräsentationen.
Dadurch kann die Beschreibung trotz unterschiedlicher Formulierung als relevantes Ergebnis erscheinen.
Wichtig: Die Datenbank erkennt nicht selbstständig, was ein Text bedeutet. Sie berechnet Ähnlichkeiten zwischen den Vektoren, die ihr bereitgestellt werden.
Wie gut diese Ähnlichkeiten zur tatsächlichen Bedeutung passen, hängt insbesondere vom verwendeten Embedding-Modell ab.
Warum sind Vektordatenbanken für künstliche Intelligenz wichtig?
Viele moderne KI-Anwendungen benötigen Informationen, die außerhalb der trainierten Modellparameter liegen.
Ein Sprachmodell kann beispielsweise allgemeine Fragen über einen bestimmten Themenbereich beantworten.
Es kennt aber nicht automatisch die aktuellen Inhalte einer privaten Unternehmensdatenbank.
Ein Retrieval-System kann solche Informationen gezielt suchen und bereitstellen.
Vektordatenbanken ermöglichen dabei eine Suche nach mathematischer Ähnlichkeit.
Das ist besonders hilfreich, wenn:
- Nutzer ihre Fragen unterschiedlich formulieren.
- Dokumente Synonyme und verwandte Fachbegriffe enthalten.
- Große Textbestände durchsucht werden müssen.
- Ähnliche Produkte oder Bilder gefunden werden sollen.
- Ein KI-Assistent relevante Wissensinhalte benötigt.
- Inhalte aus unterschiedlichen Sprachen verglichen werden sollen.
Vektordatenbanken werden deshalb häufig zusammen mit Large Language Models und RAG-Systemen eingesetzt.
Sie sind jedoch nicht für jede KI-Anwendung erforderlich.
Eine einfache Datenbankabfrage nach einer Kundennummer oder einem Produktpreis funktioniert häufig ohne zusätzliche Vektorsuche.
Was sind Embeddings?
Embeddings sind numerische Repräsentationen von Informationen in Form mathematischer Vektoren.
Ein Embedding-Modell wandelt beispielsweise einen Satz in eine geordnete Liste von Zahlen um.
Ein stark vereinfachtes Beispiel:
[0.21, -0.48, 0.73, 0.09, -0.15]
In der Praxis besitzen solche Vektoren häufig mehrere Hundert oder Tausend Dimensionen.
Durch das Training des Embedding-Modells entstehen Repräsentationsräume, in denen ähnliche Inhalte häufig mathematisch ähnliche Vektoren erhalten.
Ein Beispiel:
„Ein Hund liegt auf dem Sofa.“
„Ein Haustier ruht auf der Couch.“
Ein geeignetes Text-Embedding-Modell kann zwischen diesen Aussagen eine hohe semantische Ähnlichkeit erkennen.
Eine völlig andere Aussage wie:
„Die Börse öffnet um neun Uhr.“
könnte deutlich weniger ähnlich repräsentiert werden.
Diese Beziehungen sind allerdings modellabhängig.
Eine hohe Vektorähnlichkeit bedeutet nicht zwangsläufig, dass zwei Aussagen fachlich übereinstimmen.
Die technischen Grundlagen erklären wir ausführlich unter Embeddings einfach erklärt.
Was ist ein Vektorraum?
Ein Vektorraum ist ein mathematischer Raum, in dem Vektoren anhand ihrer numerischen Koordinaten dargestellt und miteinander verglichen werden können.
Zum Verständnis hilft eine vereinfachte Vorstellung.
Stell dir eine Bibliothek vor, deren Bücher nicht alphabetisch sortiert sind.
Stattdessen liegen Bücher über ähnliche Themen möglichst nahe beieinander.
Ein Buch über Machine Learning könnte beispielsweise in der Nähe anderer KI-Fachbücher liegen.
Ein Reiseführer würde möglicherweise in einer anderen Region stehen.
Ein Embedding-Modell erzeugt eine solche Anordnung nicht in einem gewöhnlichen dreidimensionalen Raum, sondern häufig mit Hunderten oder Tausenden Dimensionen.
Eine Vektordatenbank kann anschließend mathematisch nach benachbarten Vektoren suchen.
Dabei muss die Ähnlichkeit anhand eines geeigneten Distanz- oder Ähnlichkeitsmaßes definiert werden.
Wie funktioniert eine Vektordatenbank?
Der grundlegende Ablauf lässt sich in mehrere Schritte unterteilen.
1. Datenquellen auswählen
Zunächst werden die Informationen bestimmt, die später durchsuchbar sein sollen.
Dazu können gehören:
- Fachartikel
- Produktbeschreibungen
- PDFs
- Bedienungsanleitungen
- Support-Dokumentationen
- Kundenanfragen
- Bilder und andere Medien
2. Inhalte aufbereiten
Die Daten werden in eine geeignete Struktur gebracht.
Bei Textdokumenten können beispielsweise unnötige HTML-Elemente entfernt und Überschriften berücksichtigt werden.
Bei größeren Dokumenten wird der Inhalt häufig in kleinere Abschnitte aufgeteilt.
Diesen Prozess nennt man Chunking.
3. Embeddings erzeugen
Ein geeignetes Embedding-Modell verarbeitet die Inhalte und erstellt numerische Vektoren.
Diese Vektoren repräsentieren bestimmte erlernte Eigenschaften der jeweiligen Texte oder Medieninhalte.
4. Vektoren und Metadaten speichern
Die Vektoren werden in der Datenbank gespeichert.
Zusätzlich können Informationen wie Dokumenttitel, Quelladresse, Kategorie, Sprache oder Veröffentlichungsdatum hinterlegt werden.
5. Einen Suchindex aufbauen
Für größere Datenmengen werden häufig spezielle Indexverfahren verwendet.
Diese ermöglichen eine schnelle Suche, ohne jeden gespeicherten Vektor vollständig vergleichen zu müssen.
6. Nutzeranfrage verarbeiten
Stellt ein Benutzer eine Suchanfrage, wird auch diese in eine kompatible numerische Repräsentation umgewandelt.
7. Ähnliche Vektoren suchen
Die Datenbank sucht nach gespeicherten Vektoren, die gemäß dem verwendeten Ähnlichkeitsmaß besonders gut zur Anfrage passen.
8. Ergebnisse zurückgeben
Die Anwendung erhält die entsprechenden Datensätze, Dokumentabschnitte oder Quellenreferenzen.
Diese können direkt angezeigt oder an ein Sprachmodell weitergegeben werden.
Vektordatenbank oder klassische Datenbank: Was ist der Unterschied?
Klassische relationale Datenbanken verwalten strukturierte Informationen wie Kundendaten, Rechnungen oder Bestellungen.
Typische Datenbankabfragen suchen nach exakten Werten oder prüfen bestimmte Bedingungen.
Beispiele sind:
„Zeige alle Rechnungen aus dem September.“
„Finde die Bestellung mit der Nummer 14582.“
Eine Vektorsuche beantwortet dagegen Fragen wie:
„Welche Dokumente beschäftigen sich mit einem ähnlichen technischen Problem?“
| Eigenschaft | Relationale Datenbank | Vektorsuche |
|---|---|---|
| Typische Daten | Tabellen und strukturierte Werte | Numerische Vektoren und Metadaten |
| Häufige Abfragen | SQL, Joins und Filter | Ähnlichkeits- und Nachbarschaftssuche |
| Exakte Identifikatoren | Besonders geeignet | Nicht die primäre Stärke |
| Semantische Suche | Mit Erweiterungen möglich | Typisches Einsatzgebiet |
| Transaktionen | Bei relationalen Systemen zentral | Je nach Datenbanksystem |
| Kombination mit Metadaten | Ja | Häufig ebenfalls möglich |
Diese Gegenüberstellung beschreibt unterschiedliche Funktionen und nicht zwangsläufig unterschiedliche Produkte.
PostgreSQL kann beispielsweise sowohl relationale Daten als auch Vektoren verwalten.
Auch moderne Suchmaschinen unterstützen häufig zusätzlich eine Vektorsuche.
Eine eigene Vektordatenbank ist deshalb nicht immer notwendig.
Was ist Similarity Search?
Similarity Search bezeichnet die Suche nach mathematisch ähnlichen Datenpunkten.
Bei Vektordatenbanken werden dafür numerische Vektoren verglichen.
Ein Nutzer stellt beispielsweise eine Suchanfrage.
Das System erzeugt daraus einen Anfragevektor.
Anschließend sucht die Datenbank nach den Vektoren, die gemäß dem gewählten Ähnlichkeitsmaß am besten dazu passen.
Für diese Vergleiche gibt es unterschiedliche mathematische Verfahren.
Kosinus-Ähnlichkeit
Die Kosinus-Ähnlichkeit vergleicht die Richtung zweier Vektoren.
Ein hoher Wert kann auf eine große Übereinstimmung der Vektorrichtungen hinweisen.
Bei bestimmten normalisierten Embedding-Modellen ist dieses Verfahren besonders verbreitet.
Euklidische Distanz
Die euklidische Distanz misst den mathematischen Abstand zwischen zwei Punkten.
Je kleiner die Distanz, desto näher liegen die Vektoren nach diesem Maß beieinander.
Skalarprodukt
Das Skalarprodukt berücksichtigt die numerischen Komponenten zweier Vektoren.
Bei normalisierten Vektoren kann es für bestimmte Ranking-Aufgaben dieselbe Ergebnisreihenfolge wie die Kosinus-Ähnlichkeit liefern.
Welches Verfahren ist das beste?
Das hängt vom verwendeten Embedding-Modell ab.
Einige Modelle werden ausdrücklich für bestimmte Ähnlichkeitsmaße trainiert.
Die Empfehlungen des jeweiligen Modellanbieters sollten deshalb berücksichtigt werden.
Eine Ähnlichkeit von 0,90 bedeutet nicht automatisch, dass zwei Texte inhaltlich zu 90 Prozent übereinstimmen.
Es handelt sich um einen mathematischen Wert, dessen Interpretation vom verwendeten Modell und Verfahren abhängt.
Was ist Nearest Neighbor Search?
Nearest Neighbor Search bezeichnet die Suche nach den nächsten Nachbarn eines Datenpunkts.
Bei einer Vektordatenbank sind damit die Vektoren gemeint, die einem Anfragevektor gemäß einem definierten Distanzmaß am nächsten liegen.
Eine verbreitete Variante ist die k-Nearest-Neighbor-Suche (k-NN).
Dabei werden beispielsweise die fünf ähnlichsten gespeicherten Vektoren gesucht.
Der Wert k bestimmt, wie viele Nachbarn zurückgegeben werden sollen.
Ein einfaches Beispiel:
Eine Suchanfrage wird in einen Vektor umgewandelt.
Die Datenbank ermittelt die zehn ähnlichsten Dokumentabschnitte.
Diese zehn Treffer können anschließend angezeigt oder durch weitere Verfahren bewertet werden.
Bei großen Datensätzen stellt sich jedoch eine technische Herausforderung:
Wie findet man ähnliche Vektoren schnell, ohne jedes Mal sämtliche Einträge vollständig zu durchsuchen?
Exakte Suche und Approximate Nearest Neighbor Search
Bei einer exakten Vektorsuche werden die relevanten Kandidaten so durchsucht, dass tatsächlich die mathematisch nächsten Nachbarn gefunden werden.
Dieses Verfahren kann bei kleinen Datenbeständen ausreichend schnell sein.
Bei Millionen von Vektoren kann eine vollständige Suche jedoch aufwendig werden.
Deshalb verwenden viele Systeme Approximate Nearest Neighbor Search (ANN).
ANN-Verfahren suchen nach sehr guten Näherungsergebnissen.
Sie reduzieren den Suchaufwand, können dabei aber einzelne tatsächlich nächstgelegene Vektoren übersehen.
| Eigenschaft | Exakte Suche | ANN-Suche |
|---|---|---|
| Ergebnis | Mathematisch exakte nächste Nachbarn | Näherungsweise nächste Nachbarn |
| Geschwindigkeit | Bei großen Datenmengen potenziell aufwendig | Häufig deutlich schneller |
| Zusätzlicher Index | Nicht immer erforderlich | Üblicherweise |
| Suchqualität | Vollständige Genauigkeit des Nachbarschaftsvergleichs | Abhängig von Index und Parametern |
| Typischer Einsatz | Kleine Datenbestände und Qualitätsreferenz | Große Suchsysteme |
ANN ist besonders dann sinnvoll, wenn eine geringe Abweichung bei der Trefferauswahl zugunsten besserer Suchgeschwindigkeit akzeptabel ist.
Die tatsächlichen Qualitätsverluste müssen jedoch gemessen werden.
Was ist HNSW?
HNSW steht für Hierarchical Navigable Small World.
Es ist eines der wichtigsten Verfahren zur schnellen näherungsweisen Suche nach ähnlichen Vektoren.
Der Algorithmus wurde von Yu. A. Malkov und Dmitry Yashunin entwickelt.
HNSW organisiert Datenpunkte in einer mehrschichtigen Graphstruktur.
Wie funktioniert HNSW?
Statt jeden gespeicherten Vektor einzeln mit der Anfrage zu vergleichen, nutzt das Verfahren Verbindungen zwischen ähnlichen Datenpunkten.
Die oberen Graphschichten enthalten weniger Knoten und dienen der groben Navigation.
In tieferen Schichten wird die Suche zunehmend verfeinert.
Ein Vergleich aus dem Alltag:
Stell dir vor, du suchst eine bestimmte Adresse in einer großen Stadt.
Zuerst verwendest du große Hauptstraßen, um die richtige Region zu erreichen.
Danach wechselst du auf kleinere Straßen und näherst dich dem konkreten Ziel.
HNSW verfolgt ein vergleichbares mehrstufiges Suchprinzip.
Welche Vorteile besitzt HNSW?
HNSW bietet bei geeigneten Einstellungen häufig ein gutes Verhältnis zwischen Suchgeschwindigkeit und Trefferqualität.
Deshalb wird es in zahlreichen Vektorsuchsystemen eingesetzt.
Welche Nachteile besitzt HNSW?
Die Graphstruktur benötigt zusätzlichen Speicher.
Auch der Aufbau des Index kann vergleichsweise aufwendig sein.
Bei sehr großen Datenmengen müssen diese Anforderungen berücksichtigt werden.
Wichtige HNSW-Parameter
Zu den bekannten Einstellungen gehören:
M: Beeinflusst die Anzahl der Graphverbindungen.
efConstruction: Beeinflusst den Aufwand beim Aufbau des Index.
efSearch: Steuert beziehungsweise beeinflusst die Suchbreite während einer Anfrage.
Die genaue Bezeichnung und Wirkung einzelner Einstellungen hängt von der jeweiligen Implementierung ab.
Ein höherer Suchaufwand kann bessere Treffer liefern, benötigt aber häufig mehr Zeit und Ressourcen.
Was ist IVFFlat?
IVFFlat ist ein weiteres verbreitetes Indexverfahren für ANN-Suche.
IVF steht für Inverted File.
Das Verfahren teilt Vektoren in Gruppen ein.
Diese Gruppen orientieren sich an bestimmten mathematischen Zentren, häufig Centroids genannt.
Bei einer Suchanfrage werden nicht zwangsläufig alle Gruppen durchsucht.
Stattdessen konzentriert sich das System auf ausgewählte Gruppen, die zur Anfrage passen.
Beispiel
Eine Datenbank enthält eine Million Vektoren.
IVFFlat organisiert sie in zahlreiche Gruppen.
Bei einer Anfrage werden zunächst die am besten passenden Gruppen bestimmt.
Anschließend werden nur die entsprechenden Kandidaten genauer verglichen.
Dadurch kann der Suchaufwand sinken.
Vorteile von IVFFlat
Das Verfahren besitzt gegenüber HNSW in bestimmten Implementierungen einen geringeren Speicherbedarf und kann schneller aufgebaut werden.
Nachteile von IVFFlat
Die Suchqualität hängt stark davon ab, wie viele Gruppen durchsucht werden.
Werden zu wenige Gruppen berücksichtigt, können wichtige Treffer übersehen werden.
Bei pgvector sollte der IVFFlat-Index außerdem möglichst auf einer bereits ausreichend befüllten Tabelle aufgebaut werden.
HNSW und IVFFlat im Vergleich
| Merkmal | HNSW | IVFFlat |
|---|---|---|
| Indexstruktur | Mehrschichtiger Graph | Gruppierung der Vektoren |
| Suchqualität | Häufig sehr gutes Geschwindigkeits-Recall-Verhältnis | Stark von Suchparametern abhängig |
| Speicherbedarf | Häufig höher | Häufig geringer |
| Indexaufbau | Vergleichsweise aufwendig | Oft einfacher |
| Einsatzgebiet | Leistungsfähige ANN-Suche | Ressourcenschonende ANN-Alternative |
| Verfügbarkeit | In vielen Vektorsystemen | In mehreren Datenbanken und Bibliotheken |
Keines der Verfahren ist in jeder Situation grundsätzlich überlegen.
Die Wahl hängt von Datenmenge, Aktualisierungshäufigkeit, Speicherbudget und geforderter Suchqualität ab.
Was ist Recall@k?
Bei einer näherungsweisen Vektorsuche muss überprüft werden, ob die tatsächlich relevanten Nachbarn gefunden werden.
Eine häufig verwendete Kennzahl ist Recall@k.
Dabei wird gemessen, welcher Anteil der relevanten beziehungsweise bei der Referenzsuche ermittelten Treffer unter den ersten k Ergebnissen erscheint.
Ein einfaches Beispiel:
Die exakte Suche findet die zehn mathematisch nächsten Nachbarn.
Eine ANN-Suche findet davon neun.
Der Recall@10 gegenüber dieser exakten Referenz beträgt 90 Prozent.
Diese Kennzahl ist wichtig, um Geschwindigkeit und Suchqualität gegeneinander abzuwägen.
Allerdings sollte zwischen technischem ANN-Recall und fachlicher Dokumentrelevanz unterschieden werden.
Ein ANN-System kann die nächsten Vektoren zuverlässig finden, obwohl diese inhaltlich nicht die besten Antworten auf eine Nutzerfrage liefern.
Was ist Hybrid Search?
Hybrid Search kombiniert unterschiedliche Suchverfahren, häufig klassische Keyword-Suche und semantische Vektorsuche.
Das Ziel besteht darin, die Stärken beider Verfahren zu nutzen.
Eine Vektorsuche erkennt häufig semantisch verwandte Formulierungen.
Eine Keyword-Suche ist dagegen besonders bei konkreten Begriffen, Produktnummern und exakten Zeichenfolgen hilfreich.
Beispiel
Ein Nutzer sucht:
„Fehlercode E104 bei einer Solaranlage“.
Für die Suche ist der genaue Code „E104“ besonders wichtig.
Eine reine semantische Suche könnte andere Fehlerberichte mit ähnlichem Inhalt finden, aber den konkreten Code unzureichend berücksichtigen.
Eine Keyword-Suche kann die exakte Kennung gezielt finden.
Hybrid Search kann beide Ansätze miteinander verbinden.
Was ist BM25?
BM25 ist ein etabliertes Rankingverfahren der klassischen Textsuche.
Es berücksichtigt unter anderem die Häufigkeit eines Suchbegriffs, seine Verbreitung innerhalb des Dokumentbestands und die Dokumentlänge.
BM25 wird häufig mit semantischer Vektorsuche kombiniert.
Dense und Sparse Retrieval
Dense Retrieval verwendet meist dichte numerische Vektoren mit vielen kontinuierlichen Werten.
Sparse Retrieval verwendet Repräsentationen, in denen nur ein kleiner Teil der möglichen Merkmale ungleich null ist.
Dazu können klassische und lernbasierte textorientierte Verfahren gehören.
Moderne Suchsysteme können beide Varianten gemeinsam verarbeiten.
Wie funktioniert Reciprocal Rank Fusion (RRF)?
Wenn unterschiedliche Suchverfahren verwendet werden, entstehen häufig mehrere Ergebnislisten.
Die Keyword-Suche könnte beispielsweise Dokument A auf Platz eins setzen.
Die Vektorsuche bewertet dagegen Dokument B als besonders passend.
Diese Rankings müssen sinnvoll zusammengeführt werden.
Ein bekanntes Verfahren ist Reciprocal Rank Fusion (RRF).
Dabei werden die Positionen der Treffer innerhalb der unterschiedlichen Listen berücksichtigt.
Dokumente, die in mehreren Listen weit oben stehen, können dadurch bevorzugt werden.
RRF wird unter anderem von Microsoft Azure AI Search und Qdrant unterstützt.
Warum ist RRF nützlich?
Die Suchverfahren verwenden häufig unterschiedliche Bewertungsskalen.
RRF kann Rankings zusammenführen, ohne dass deren ursprüngliche Scores direkt miteinander vergleichbar sein müssen.
Das Verfahren garantiert jedoch nicht automatisch die beste Ergebnisqualität.
Auch die Auswahl der Suchverfahren und die Qualität der zugrunde liegenden Daten bleiben wichtig.
Was ist Re-Ranking?
Re-Ranking bezeichnet die erneute Bewertung bereits gefundener Suchtreffer.
Ein Suchsystem könnte beispielsweise zunächst 30 relevante Dokumentabschnitte ermitteln.
Anschließend bewertet ein zusätzliches Modell diese Kandidaten genauer.
Das Ziel besteht darin, die tatsächlich wichtigsten Ergebnisse weiter oben zu platzieren.
Warum ist Re-Ranking sinnvoll?
Die erste Suchphase ist häufig auf Geschwindigkeit optimiert.
Ein Re-Ranker kann dagegen für eine kleinere Kandidatenmenge eine aufwendigere Bewertung durchführen.
Was ist ein Cross-Encoder?
Ein Cross-Encoder verarbeitet eine Suchanfrage und einen Dokumentabschnitt gemeinsam.
Dadurch kann er deren Beziehung genauer untersuchen, als dies bei manchen reinen Vektorvergleichen möglich ist.
Was sind Late-Interaction-Modelle?
Einige moderne Verfahren verwenden mehrere Vektoren pro Dokument oder Textabschnitt.
Sie können dadurch detailliertere Beziehungen zwischen Anfrage und Dokument abbilden.
Ein Beispiel ist die ColBERT-Modellfamilie.
Qdrant dokumentiert entsprechende Kombinationen aus Hybrid Search und Re-Ranking.
Nachteile
Zusätzliche Bewertungsstufen erhöhen Rechenaufwand und Bearbeitungszeit.
Außerdem kann ein Re-Ranker nur die Treffer bewerten, die zuvor gefunden wurden.
Ein bereits vollständig übersehener wichtiger Treffer lässt sich durch nachgelagertes Re-Ranking nicht wiederherstellen.
Was ist pgvector?
pgvector ist eine Open-Source-Erweiterung für PostgreSQL, die Vektorsuche innerhalb einer relationalen Datenbank ermöglicht.
Dadurch können klassische Daten und numerische Vektoren gemeinsam verwaltet werden.
Ein Unternehmen könnte beispielsweise Produktinformationen in PostgreSQL speichern.
Zusätzlich erhält jede Produktbeschreibung ein Embedding.
Die Anwendung kann dann sowohl nach exakten Produktmerkmalen filtern als auch ähnliche Produktbeschreibungen suchen.
Welche Funktionen unterstützt pgvector?
Zu den wichtigen Möglichkeiten gehören:
- Speicherung numerischer Vektoren
- Exakte Ähnlichkeitssuche
- HNSW-Indizes
- IVFFlat-Indizes
- Unterschiedliche Distanzfunktionen
- Kombination mit SQL-Abfragen
- Metadatenfilter und relationale Verknüpfungen
- Unterschiedliche Vektorformate und Präzisionsstufen
Warum ist pgvector interessant?
Wenn eine Anwendung bereits PostgreSQL verwendet, kann eine zusätzliche eigenständige Vektordatenbank unnötig sein.
Vorhandene Daten, Benutzerrechte und Datenbankprozesse lassen sich möglicherweise weiterverwenden.
Wo liegen die Grenzen?
Bei sehr großen Datenbeständen oder anspruchsvollen Skalierungsanforderungen können spezialisierte Systeme Vorteile bieten.
Auch bei pgvector müssen Suchindex, Speicherbedarf und Abfrageplanung sorgfältig konfiguriert werden.
Insbesondere die Kombination aus ANN-Indizes und Metadatenfiltern benötigt Aufmerksamkeit.
Die offizielle Dokumentation erläutert dazu iterative Index-Scans und weitere Optimierungsmöglichkeiten.
Welche Vektordatenbanken gibt es?
Es existieren zahlreiche Lösungen mit unterschiedlichen technischen Schwerpunkten.
Die folgende Übersicht zeigt bekannte Beispiele.
| Lösung | Typ | Charakteristik |
|---|---|---|
| pgvector | PostgreSQL-Erweiterung | Vektorsuche innerhalb relationaler Daten |
| Qdrant | Spezialisierte Vektordatenbank | Vektorsuche, Filter, Hybrid Search |
| Weaviate | Vektordatenbank | Semantische und hybride Suche |
| Milvus | Spezialisierte Vektordatenbank | Umfangreiche Indexverfahren und Skalierung |
| Pinecone | Verwaltete Datenbankplattform | Cloudbasierte Vektorsuche |
| FAISS | Suchbibliothek | Effiziente Vektorindizes, keine vollständige Datenbankplattform |
| Azure AI Search | Suchplattform | Keyword-, Vektor- und hybride Suche |
Diese Lösungen unterscheiden sich unter anderem in Deployment, Funktionen, Kosten und Betriebsaufwand.
Für die Auswahl sollte deshalb nicht allein die Popularität eines Systems entscheidend sein.
Qdrant: Vektorsuche mit Hybrid Search
Qdrant ist eine spezialisierte Vektordatenbank.
Sie ermöglicht die Speicherung und Suche von Vektorrepräsentationen mit zusätzlichen Metadaten.
Zu den Funktionen gehören unterschiedliche Such- und Filtermöglichkeiten.
Qdrant unterstützt außerdem hybride Abfragen, bei denen mehrere Suchverfahren kombiniert werden.
Dabei können beispielsweise Dense Retrieval und BM25-basierte Textsuche gemeinsam eingesetzt werden.
Auch mehrstufige Abfragen und Re-Ranking-Verfahren sind dokumentiert.
Qdrant kann daher eine geeignete Lösung für Suchanwendungen sein, die mehr als eine reine Vektorähnlichkeitssuche benötigen.
Weaviate: Vektor- und Keyword-Suche
Weaviate ist eine Vektordatenbankplattform mit Funktionen für semantische und hybride Suche.
Weaviate unterstützt unter anderem Vektorindizes, Metadatenfilter und die Kombination von BM25 mit Vektorsuche.
Auch unterschiedliche Verfahren zur Fusion von Suchergebnissen sind verfügbar.
Die Plattform eignet sich für Anwendungen, die strukturierte Informationen und semantische Suchfunktionen miteinander verbinden möchten.
Welche Konfiguration sinnvoll ist, hängt von Datensatz, Anforderungen und Deployment ab.
Milvus: Vektorsuche für umfangreiche Datenbestände
Milvus ist eine Open-Source-Vektordatenbank, die auch für große Datenbestände und verteilte Architekturen entwickelt wird.
Die Plattform unterstützt verschiedene Indexverfahren.
Dazu gehören unter anderem HNSW sowie unterschiedliche IVF- und Quantisierungsvarianten.
Milvus stellt außerdem Funktionen für verschiedene Vektortypen bereit.
Eine entsprechende Infrastruktur kann bei sehr großen Datenbeständen sinnvoll sein.
Dafür müssen allerdings Deployment, Skalierung und Betriebsaufwand berücksichtigt werden.
Pinecone: Verwaltete Vektordatenbank
Pinecone bietet eine verwaltete Plattform für Vektorsuche und verwandte Suchverfahren.
Ein Vorteil solcher Dienste besteht darin, dass bestimmte Infrastrukturaufgaben vom Anbieter übernommen werden.
Dafür entstehen Abhängigkeiten von dessen Preisstruktur, Dienstverfügbarkeit und Nutzungsbedingungen.
Auch Datenschutz und die tatsächliche Region der Datenverarbeitung sind zu prüfen.
Verwaltete Dienste können besonders interessant sein, wenn ein Unternehmen den technischen Eigenbetrieb reduzieren möchte.
FAISS: Bibliothek statt vollständiger Datenbank
FAISS steht für Facebook AI Similarity Search.
Es handelt sich um eine Bibliothek zur effizienten Ähnlichkeitssuche und zum Clustering numerischer Vektoren.
FAISS wurde wesentlich durch die KI-Forschung von Meta entwickelt.
Die Bibliothek bietet unterschiedliche Such- und Indexverfahren.
Sie kann für lokale Experimente und leistungsfähige Suchlösungen verwendet werden.
Allerdings ist FAISS nicht mit einer vollständigen Datenbankplattform gleichzusetzen.
Funktionen wie Benutzerverwaltung, umfassende Datenpersistenz und bestimmte Betriebsmechanismen müssen bei einer eigenen Architektur gegebenenfalls zusätzlich umgesetzt werden.
Wie wählt man die richtige Vektordatenbank aus?
Die Auswahl hängt von mehreren Anforderungen ab.
Datenmenge
Wie viele Vektoren müssen gespeichert werden?
Eine kleine Wissenswebsite benötigt normalerweise eine andere Architektur als eine Plattform mit mehreren Hundert Millionen Datensätzen.
Suchqualität
Wie genau müssen die Ergebnisse sein?
Reicht ANN-Suche aus, oder werden exakte Vergleiche benötigt?
Geschwindigkeit
Welche Antwortzeiten sind akzeptabel?
Ein interaktiver Chatbot besitzt andere Anforderungen als eine nächtliche Datenanalyse.
Metadaten und Filter
Müssen Suchergebnisse nach Sprache, Kategorie, Datum oder Benutzerrechten gefiltert werden?
Vorhandene Infrastruktur
Wird bereits PostgreSQL oder eine andere Datenbank verwendet?
Dann kann eine Erweiterung möglicherweise einfacher sein als ein zusätzlicher Datenbankdienst.
Datenschutz
Wo werden die Daten verarbeitet?
Welche Zugriffskontrollen und Löschmöglichkeiten stehen zur Verfügung?
Betriebskosten
Zu berücksichtigen sind unter anderem Speicher, Rechenleistung, Datenübertragung und Wartung.
Skalierung
Muss die Anwendung viele gleichzeitige Suchanfragen bearbeiten?
Ein System sollte anhand des tatsächlichen erwarteten Betriebs ausgewählt werden.
Welche Rolle spielen Vektordatenbanken bei RAG?
Retrieval-Augmented Generation (RAG) verbindet ein generatives KI-Modell mit einem externen Informationsabruf.
Eine häufig verwendete Architektur besteht aus einem Embedding-Modell, einer Vektordatenbank und einem Large Language Model.
Ein Nutzer stellt beispielsweise die Frage:
„Welche Sicherheitsmaßnahmen sind bei der Verarbeitung von Kundendaten erforderlich?“
Das System erzeugt ein Embedding der Anfrage.
Die Vektordatenbank sucht passende Dokumentabschnitte.
Diese werden dem Sprachmodell als zusätzlicher Kontext bereitgestellt.
Anschließend erstellt das Modell eine Antwort.
Was ist dabei wichtig?
Die Qualität der Antwort hängt davon ab, ob tatsächlich die richtigen Informationen gefunden werden.
Ein semantisch ähnlicher Text kann unvollständig oder veraltet sein.
Auch das Sprachmodell kann die gefundenen Informationen falsch interpretieren.
Deshalb benötigt ein produktives RAG-System geeignete Quellenkontrollen und Qualitätsprüfungen.
RAG benötigt außerdem nicht zwingend eine Vektordatenbank.
Auch Volltextsuche, SQL-Abfragen und andere Retrieval-Verfahren sind möglich.
Mehr dazu unter Retrieval-Augmented Generation einfach erklärt.
Was ist Chunking?
Chunking bezeichnet die Aufteilung umfangreicher Inhalte in kleinere Abschnitte.
Bei langen Dokumenten ist es häufig unpraktisch, den gesamten Inhalt mit nur einem Embedding zu repräsentieren.
Ein Dokument könnte beispielsweise unterschiedliche Themen enthalten.
Wenn der gesamte Text zu einer einzigen Vektordarstellung verdichtet wird, können wichtige Einzelinformationen bei der Suche untergehen.
Deshalb werden häufig einzelne Absätze oder zusammenhängende Textabschnitte eingebettet.
Zu kleine Chunks
Sehr kleine Abschnitte können den erforderlichen Zusammenhang verlieren.
Zu große Chunks
Sehr große Abschnitte können mehrere Themen vermischen und unnötig viel Kontext verbrauchen.
Structure-Aware Chunking
Ein besonders sinnvoller Ansatz berücksichtigt die tatsächliche Dokumentstruktur.
Dazu gehören Überschriften, Kapitel, Absätze und Tabellen.
Für WordPress-Fachartikel können die H2- und H3-Abschnitte eine geeignete Grundlage für die Aufteilung bilden.
Die optimale Chunkgröße muss jedoch anhand realer Suchanfragen getestet werden.
Warum sind Metadaten wichtig?
Ein Embedding allein enthält normalerweise nicht sämtliche Informationen, die für eine zuverlässige Suche erforderlich sind.
Deshalb speichern Vektordatenbanken häufig zusätzliche Metadaten.
Dazu können gehören:
- Dokument-ID
- Titel
- URL
- Kategorie
- Sprache
- Veröffentlichungsdatum
- Letzte Aktualisierung
- Abschnittsnummer
- Dokumentversion
- Benutzer- oder Mandantenberechtigung
Ein Suchsystem kann diese Informationen verwenden, um Ergebnisse einzugrenzen.
Beispielsweise könnte eine Anfrage nur aktuelle deutschsprachige Fachartikel berücksichtigen.
Bei Unternehmensdaten können Metadaten außerdem Teil eines technischen Berechtigungskonzepts sein.
Die Autorisierung muss allerdings unabhängig davon zuverlässig durchgesetzt werden.
Wie viel Speicher benötigen Vektordatenbanken?
Der Speicherbedarf hängt von der Anzahl der Vektoren, ihrer Dimension und dem verwendeten Datenformat ab.
Ein vereinfachtes Beispiel:
Ein Embedding besitzt 1.536 Dimensionen.
Jeder Zahlenwert wird als 32-Bit-Gleitkommazahl gespeichert und benötigt vier Byte.
Damit ergibt sich:
1.536 × 4 Byte = 6.144 Byte pro Vektor
Bei 100.000 Vektoren entstehen ungefähr 614 MB reine Vektordaten.
Dieser Wert berücksichtigt noch keine Suchindizes, Metadaten, Dokumenttexte oder zusätzlichen Datenbankstrukturen.
Bei Millionen von Vektoren kann der Speicherbedarf daher erheblich werden.
Was beeinflusst den Speicherverbrauch?
Neben der Datenmenge spielen insbesondere folgende Faktoren eine Rolle:
Vektordimension: Mehr Dimensionen benötigen bei gleichem Format mehr Speicher.
Numerische Präzision: Unterschiedliche Datentypen benötigen unterschiedlich viel Speicher.
Indexverfahren: Eine HNSW-Graphstruktur verursacht zusätzlichen Speicherbedarf.
Metadaten: Gespeicherte Texte und Zusatzinformationen benötigen ebenfalls Platz.
Replikation: Mehrfache Datenhaltung erhöht den Gesamtbedarf.
Eine wirtschaftliche Planung sollte deshalb die vollständige Infrastruktur berücksichtigen.
Was bedeutet Quantisierung bei Vektordatenbanken?
Quantisierung beschreibt Verfahren, mit denen numerische Werte in einer kompakteren Darstellung gespeichert oder verarbeitet werden.
Dadurch kann der Speicherbedarf reduziert werden.
Bei großen Vektordatenbeständen können beispielsweise niedrigere numerische Präzisionen oder spezielle Komprimierungsverfahren eingesetzt werden.
Zu den bekannten Ansätzen gehören Scalar Quantization, Product Quantization und binäre Verfahren.
Vorteile
Der Speicherbedarf kann sinken.
Unter geeigneten Bedingungen lassen sich auch Suchgeschwindigkeit und Skalierbarkeit verbessern.
Nachteile
Durch die reduzierte Präzision können Informationen verloren gehen.
Dadurch kann sich die Qualität der Suchergebnisse verändern.
Quantisierung mit Re-Ranking
Ein System kann zunächst über kompakte Vektorrepräsentationen nach Kandidaten suchen.
Anschließend werden ausgewählte Ergebnisse mithilfe genauerer Originalvektoren oder eines zusätzlichen Re-Rankers bewertet.
Dadurch lässt sich ein Kompromiss zwischen Speicherbedarf und Suchqualität erreichen.
Wie aktualisiert man eine Vektordatenbank?
Eine Vektordatenbank muss mit den zugrunde liegenden Inhalten synchron bleiben.
Wenn ein Artikel geändert oder gelöscht wird, sollten auch die dazugehörigen Suchdaten entsprechend aktualisiert werden.
Ein typischer Ablauf könnte so aussehen:
- Das System erkennt einen neuen oder aktualisierten Inhalt.
- Die betroffenen Textabschnitte werden erneut aufbereitet.
- Für geänderte Abschnitte werden neue Embeddings erzeugt.
- Alte Vektoren werden ersetzt oder entfernt.
- Metadaten und Quellenreferenzen werden aktualisiert.
- Der Suchindex berücksichtigt die Änderungen.
Warum sind stabile Dokument-IDs wichtig?
Mit eindeutigen IDs lassen sich gespeicherte Vektoren den ursprünglichen Inhalten zuordnen.
Das erleichtert Updates und Löschungen.
Was passiert beim Wechsel des Embedding-Modells?
Bei einem Wechsel kann sich der mathematische Repräsentationsraum verändern.
Die neuen Vektoren sind deshalb nicht automatisch mit den alten kompatibel.
Häufig muss die gesamte betroffene Dokumentensammlung neu eingebettet werden.
Ein produktives System sollte deshalb die verwendete Embedding-Modellversion dokumentieren.
Vektordatenbanken und Datenschutz
Die Speicherung numerischer Embeddings bedeutet nicht automatisch, dass sämtliche Datenschutzprobleme gelöst sind.
Auch Vektoren können Informationen über die zugrunde liegenden Inhalte enthalten.
Wissenschaftliche Arbeiten haben gezeigt, dass unter bestimmten Bedingungen Informationen aus Embeddings rekonstruiert oder abgeleitet werden können.
Eine Vektordatenbank kann deshalb personenbezogene oder vertrauliche Informationen verarbeiten.
Welche Schutzmaßnahmen sind wichtig?
Zugriffskontrollen: Nur berechtigte Benutzer dürfen auf entsprechende Inhalte zugreifen.
Mandantentrennung: Kundendaten unterschiedlicher Organisationen müssen zuverlässig getrennt werden.
Verschlüsselung: Geeignete Maßnahmen für Speicherung und Übertragung sind notwendig.
Datenminimierung: Nicht erforderliche personenbezogene Informationen sollten vermieden werden.
Löschkonzepte: Auch Vektoren, Indizes, Kopien und zugehörige Metadaten müssen berücksichtigt werden.
Protokollierung: Sicherheitsrelevante Zugriffe sollten angemessen nachvollziehbar sein.
Der Einsatz einer lokalen Vektordatenbank kann mehr Kontrolle über die Infrastruktur ermöglichen.
Er führt jedoch nicht automatisch zur vollständigen Einhaltung der DSGVO.
Welche Sicherheitsrisiken bestehen bei Vektordatenbanken?
Die OWASP Top 10 für LLM-Anwendungen behandeln unter anderem Risiken unter der Bezeichnung Vector and Embedding Weaknesses.
Besonders relevant sind Anwendungen, bei denen externe Inhalte in KI-Wissenssysteme übernommen werden.
Unberechtigter Datenabruf
Eine unzureichende Berechtigungsprüfung kann dazu führen, dass Benutzer Informationen erhalten, auf die sie keinen Zugriff haben sollten.
Manipulierte Dokumente
Wenn ein Angreifer Dokumente verändern oder in den Suchindex einschleusen kann, können spätere KI-Antworten beeinflusst werden.
Prompt Injection
Ein abgerufenes Dokument kann Anweisungen enthalten, die versuchen, das Verhalten eines Sprachmodells zu verändern.
Die Anwendung muss deshalb zwischen vertrauenswürdigen Steuerungsanweisungen und nicht vertrauenswürdigen Dokumentinhalten unterscheiden.
Fehlende Mandantentrennung
Bei mehreren Kunden darf eine Suche nicht versehentlich Informationen eines anderen Mandanten zurückgeben.
Unsichere Schnittstellen
Datenbank-APIs dürfen nicht ohne geeignete Authentifizierung und Autorisierung öffentlich erreichbar sein.
Wichtig: Ein Prompt wie „Gib keine vertraulichen Informationen aus“ ist keine ausreichende technische Zugriffskontrolle.
Berechtigungen müssen durch die Anwendung und Datenbank durchgesetzt werden.
Wie bewertet man die Suchqualität?
Die Qualität einer Vektordatenbank sollte anhand realistischer Testanfragen gemessen werden.
Dabei müssen zwei Ebenen unterschieden werden.
Technische Suchqualität
Bei ANN-Verfahren wird geprüft, wie zuverlässig die mathematisch nächsten Nachbarn gefunden werden.
Dazu eignet sich beispielsweise Recall@k gegenüber einer exakten Referenzsuche.
Fachliche Relevanz
Zusätzlich muss geprüft werden, ob die gefundenen Dokumente tatsächlich zur Nutzerfrage passen.
Dafür können unter anderem folgende Kennzahlen verwendet werden:
| Kennzahl | Bedeutung |
|---|---|
| Precision@k | Anteil relevanter Treffer unter den ersten k Ergebnissen |
| Recall@k | Anteil gefundener relevanter Treffer |
| MRR | Position des ersten relevanten Treffers |
| nDCG | Qualität einer abgestuften Trefferreihenfolge |
| Latenz | Dauer einer Suchanfrage |
| Durchsatz | Zahl bearbeitbarer Anfragen |
| Speicherbedarf | Ressourcenverbrauch des Systems |
Diese Kennzahlen sollten gemeinsam betrachtet werden.
Ein System, das schnell arbeitet, aber wichtige Dokumente regelmäßig übersieht, ist für einen Wissensassistenten möglicherweise ungeeignet.
Ebenso kann ein fachlich präziser Suchalgorithmus für eine öffentliche Website zu langsam sein.
Vektordatenbanken für WordPress-Websites
Für WordPress können Vektordatenbanken unterschiedliche Funktionen ermöglichen.
Ein Beispiel ist ein umfangreiches KI-Wissensportal mit zahlreichen Fachartikeln.
Besucher verwenden dort nicht immer dieselben Begriffe wie die Autoren.
Ein Nutzer könnte beispielsweise fragen:
„Wie findet ein Chatbot passende Informationen aus meinen Dokumenten?“
Ein semantisches Suchsystem könnte dazu Artikel über Embeddings, Vektordatenbanken und RAG finden.
Intelligente Artikelsuche
Besucher können Fragen in natürlicher Sprache formulieren.
Thematisch verwandte Beiträge
Das System kann inhaltlich verwandte Artikel erkennen und entsprechende Empfehlungen unterstützen.
Erkennung doppelter Inhalte
Sehr ähnliche Artikel oder Textabschnitte können mathematisch identifiziert und redaktionell überprüft werden.
Automatische Themencluster
Embeddings können helfen, große Artikelsammlungen in thematische Gruppen zu ordnen.
KI-Wissensassistent
Ein Sprachmodell kann über RAG relevante Informationen aus den vorhandenen Artikeln abrufen.
Was braucht eine WordPress-Integration?
Eine entsprechende Anwendung benötigt typischerweise:
- Eine Möglichkeit zum Auslesen der veröffentlichten Inhalte
- Dokumentenaufbereitung und Chunking
- Ein geeignetes Embedding-Modell
- Einen Suchindex oder eine Vektordatenbank
- Eine Schnittstelle für Suchanfragen
- Optional ein Sprachmodell für die Antwortgenerierung
- Funktionen für Updates, Löschungen und Berechtigungen
Eine Vektordatenbank muss dabei nicht zwingend direkt innerhalb von WordPress betrieben werden.
Sie kann auch als separater Dienst angebunden werden.
Praxisbeispiel: Semantische Suche für KIRatgeber
Angenommen, eine KI-Wissenswebsite besitzt mehrere Hundert Artikel.
Ein Besucher fragt:
„Was ist der Unterschied zwischen dem Trainieren eines KI-Modells und dem Abrufen externer Informationen?“
Das System könnte passende Artikel aus den Bereichen Fine-Tuning und RAG suchen.
Dafür werden die veröffentlichten Inhalte zunächst in geeignete Abschnitte zerlegt.
Anschließend werden Embeddings erzeugt und gespeichert.
Die Nutzerfrage wird ebenfalls eingebettet.
Eine Vektorsuche findet thematisch verwandte Abschnitte.
Eine zusätzliche Keyword-Suche kann technische Begriffe wie „Fine-Tuning“ und „RAG“ gezielt berücksichtigen.
Bei Bedarf werden die Ergebnisse durch Re-Ranking neu sortiert.
Anschließend erhält der Nutzer passende Artikel oder eine KI-generierte Zusammenfassung mit Quellenangaben.
Warum ist eine solche Architektur interessant?
Der Besucher muss nicht bereits sämtliche Fachbegriffe kennen.
Er kann seine Frage in gewöhnlicher Sprache formulieren.
Die Website kann dennoch passende Inhalte aus unterschiedlichen Wissensbereichen anbieten.
Was bedeutet das für SEO?
Eine semantische Suche verbessert möglicherweise die Benutzerführung und das Auffinden relevanter Inhalte.
Sie ist jedoch kein direkter Google-Rankingfaktor.
Allein die Installation einer Vektordatenbank garantiert deshalb keine besseren Suchmaschinenpositionen.
Wann lohnt sich eine Vektordatenbank wirklich?
Eine Vektordatenbank kann sinnvoll sein, wenn die Informationssuche einen wesentlichen Bestandteil einer Anwendung bildet.
Typische Situationen sind:
- Umfangreiche Dokumentensammlungen
- Wissenschatbots und RAG-Anwendungen
- Semantische Produktsuche
- Suche nach ähnlichen Bildern
- Große Support-Archive
- Empfehlungssysteme
- Mehrsprachige Informationssuche
Wann ist sie nicht notwendig?
Eine zusätzliche Vektordatenbank kann unnötig sein, wenn:
- Nur wenige Dokumente vorhanden sind.
- Einfache Keyword-Suche ausreicht.
- Ausschließlich strukturierte Daten abgefragt werden.
- Exakte Identifikatoren im Mittelpunkt stehen.
- Die Kosten den erwarteten Nutzen übersteigen.
Bei kleineren Projekten sollte zunächst geprüft werden, ob vorhandene Suchfunktionen oder eine Datenbankerweiterung genügen.
Welche Fehler sollte man vermeiden?
Bei der Entwicklung von Vektorsuchsystemen treten häufig ähnliche Probleme auf.
1. Ein ungeeignetes Embedding-Modell verwenden
Nicht jedes Modell ist für jede Sprache und jedes Fachgebiet gleichermaßen geeignet.
Die Suchqualität sollte deshalb mit realistischen Testfragen geprüft werden.
2. Dokumente unpassend aufteilen
Zu große oder zu kleine Chunks können die Qualität verschlechtern.
3. Ausschließlich auf semantische Suche setzen
Exakte Kennungen und Fachbegriffe können bei reiner Vektorsuche untergehen.
Hybrid Search kann hier Vorteile bieten.
4. Keine Metadaten speichern
Ohne eindeutige Dokument-IDs und Quelleninformationen werden spätere Aktualisierungen und Quellenangaben schwierig.
5. Keine Berechtigungen berücksichtigen
Eine technisch funktionierende Suche darf keine vertraulichen Dokumente unberechtigt offenlegen.
6. Modellversionen unkontrolliert wechseln
Unterschiedliche Embedding-Modelle können inkompatible Vektorräume erzeugen.
7. Suchqualität nicht messen
Ein überzeugender Einzeltreffer ist noch kein Nachweis für eine zuverlässige Anwendung.
8. Aktualisierungen vernachlässigen
Veraltete oder gelöschte Dokumente können weiterhin als Suchtreffer erscheinen, wenn die Indexierung nicht korrekt synchronisiert wird.
Checkliste für die Auswahl einer Vektordatenbank
Vor der Entscheidung für ein bestimmtes System sollten folgende Fragen beantwortet werden:
- Welche Datenarten sollen durchsucht werden?
- Wie viele Vektoren werden voraussichtlich gespeichert?
- Welches Embedding-Modell wird verwendet?
- Wird exakte oder näherungsweise Suche benötigt?
- Sind Hybrid Search und Re-Ranking erforderlich?
- Welche Metadaten und Filter werden benötigt?
- Welche Antwortzeiten sind akzeptabel?
- Wie werden neue oder geänderte Inhalte synchronisiert?
- Welche Zugriffskontrollen sind notwendig?
- Wie hoch sind die gesamten Betriebs- und Wartungskosten?
Ein kleiner, sorgfältig getesteter Prototyp kann helfen, unnötige Infrastrukturentscheidungen zu vermeiden.
Häufig gestellte Fragen zu Vektordatenbanken
Was ist eine Vektordatenbank einfach erklärt?
Eine Vektordatenbank speichert numerische Repräsentationen von Informationen und ermöglicht die Suche nach mathematisch ähnlichen Einträgen. Solche Vektoren werden häufig von KI-Embedding-Modellen erzeugt.
Wofür werden Vektordatenbanken verwendet?
Typische Anwendungen sind semantische Suche, RAG, Dokumentenanalyse, Produktempfehlungen und die Suche nach ähnlichen Bildern oder anderen Medieninhalten.
Was ist der Unterschied zwischen Embedding und Vektordatenbank?
Ein Embedding ist eine numerische Repräsentation eines Inhalts. Eine Vektordatenbank speichert solche Vektoren und ermöglicht ihre effiziente Suche.
Was bedeutet ANN?
ANN steht für Approximate Nearest Neighbor. Dabei werden ähnlichste Vektoren näherungsweise gesucht, um die Suche bei großen Datenbeständen zu beschleunigen.
Was ist HNSW?
HNSW ist ein graphbasiertes ANN-Indexverfahren. Es verwendet eine mehrschichtige Struktur, um ähnliche Vektoren effizient zu finden.
Was ist IVFFlat?
IVFFlat ist ein Indexverfahren, das Vektoren in Gruppen organisiert und bei Suchanfragen ausgewählte Gruppen durchsucht.
Ist HNSW besser als IVFFlat?
Nicht grundsätzlich. HNSW bietet häufig ein günstiges Verhältnis zwischen Suchgeschwindigkeit und Trefferqualität, benötigt aber mehr Speicher und einen aufwendigeren Indexaufbau. Die geeignete Lösung hängt vom Anwendungsfall ab.
Was bedeutet Hybrid Search?
Hybrid Search kombiniert unterschiedliche Suchverfahren, beispielsweise klassische Keyword-Suche und semantische Vektorsuche.
Was ist Re-Ranking?
Re-Ranking ist die erneute Bewertung bereits gefundener Suchtreffer. Ein zusätzliches Modell kann helfen, die relevantesten Ergebnisse weiter oben zu platzieren.
Was ist pgvector?
pgvector ist eine Erweiterung für PostgreSQL, mit der numerische Vektoren gespeichert und anhand ihrer Ähnlichkeit durchsucht werden können.
Braucht man für RAG eine Vektordatenbank?
Nein. RAG kann auch klassische Suchverfahren oder strukturierte Datenbankabfragen verwenden. Vektordatenbanken sind besonders für semantische Suche verbreitet.
Kann MySQL eine Vektordatenbank ersetzen?
Das hängt von Version, Erweiterungen und verwendeter Infrastruktur ab. Grundsätzlich können auch klassische Datenbankprodukte Vektorfunktionen bereitstellen. Nicht jede Installation unterstützt jedoch dieselben Indexverfahren oder die erforderliche Leistung.
Sind Vektordatenbanken kostenlos?
Es gibt Open-Source-Lösungen und kostenpflichtige verwaltete Dienste. Auch bei kostenloser Software können Kosten für Hardware, Hosting, Betrieb und Wartung entstehen.
Kann man eine Vektordatenbank lokal betreiben?
Ja. Verschiedene Lösungen lassen sich auf eigener Infrastruktur betreiben. Die tatsächlichen Hardwareanforderungen hängen von Datenmenge und Suchverfahren ab.
Sind Vektordatenbanken DSGVO-konform?
Nicht automatisch. Die Einhaltung der DSGVO hängt von den gespeicherten Daten, Zugriffskontrollen, Löschverfahren und der gesamten Verarbeitung ab.
Können Vektordatenbanken Halluzinationen verhindern?
Nein. Sie können relevante Informationen für RAG bereitstellen, garantieren jedoch weder die sachliche Richtigkeit der Quellen noch die korrekte Verarbeitung durch ein Sprachmodell.
Wie viele Vektoren kann eine Vektordatenbank speichern?
Das hängt vom Produkt, der Infrastruktur und der Konfiguration ab. Moderne Systeme können sehr große Datenbestände verarbeiten. Entscheidend ist, ob Suchqualität, Kosten und Antwortzeit bei der erwarteten Datenmenge akzeptabel bleiben.
Sind Vektordatenbanken für WordPress sinnvoll?
Sie können interessant sein, wenn eine umfangreiche Website semantische Suche, KI-Wissensassistenten oder inhaltliche Empfehlungen anbieten möchte. Für einfache Websites ohne entsprechende Anforderungen sind sie häufig unnötig.
Fazit: Vektordatenbanken ermöglichen moderne KI-Suche
Vektordatenbanken sind ein wichtiger Bestandteil vieler moderner KI-Anwendungen.
Sie ermöglichen die Speicherung und effiziente Suche numerischer Repräsentationen von Texten, Bildern und anderen Informationen.
Die eigentliche semantische Repräsentation entsteht dabei durch geeignete Embedding-Modelle.
Die Datenbank übernimmt die Speicherung, Indexierung und mathematische Ähnlichkeitssuche.
Moderne Verfahren wie HNSW und IVFFlat können die Suche in großen Datenbeständen beschleunigen.
Hybrid Search kombiniert semantische Vektorsuche mit klassischen Keyword-Verfahren.
Re-Ranking kann die Qualität der gefundenen Treffer zusätzlich verbessern.
Mit pgvector, Qdrant, Weaviate, Milvus und anderen Lösungen stehen unterschiedliche technische Ansätze zur Verfügung.
Nicht jedes Projekt benötigt dafür eine eigenständige spezialisierte Datenbank. Auch bestehende relationale Systeme können geeignete Vektorfunktionen bereitstellen.
Entscheidend bleibt die Qualität der gesamten Informationsarchitektur.
Ein gutes Embedding-Modell, geeignete Dokumentenaufteilung, passende Suchindizes, vollständige Metadaten und zuverlässige Zugriffskontrollen sind mindestens ebenso wichtig wie die Wahl des Datenbankprodukts.
Eine Vektordatenbank macht Informationen mathematisch auffindbar. Ob daraus eine zuverlässige KI-Anwendung entsteht, entscheidet die Qualität des gesamten Such- und Verarbeitungssystems.
Weiterführendes KI-Wissen
Diese Grundlagenartikel auf KIRatgeber erklären die Technologien hinter Vektordatenbanken:
- Embeddings: Numerische Repräsentationen verstehen
- Retrieval-Augmented Generation: RAG einfach erklärt
- Large Language Models und ihre Funktionsweise
- Transformer-Architektur verstehen
- KI-Modelle: Aufbau und Modellarten
- Machine Learning und Deep Learning
- Prompt Engineering und Context Engineering
- Fine-Tuning: LoRA, QLoRA und Modellanpassung
- KI-Glossar: Wichtige Fachbegriffe
Quellen und technische Dokumentationen
Die Grundlagen und beschriebenen Suchverfahren stützen sich auf wissenschaftliche Veröffentlichungen und offizielle Dokumentationen:
- pgvector: Offizielles Projekt und Dokumentation
- Malkov und Yashunin: Hierarchical Navigable Small World Graphs
- Qdrant: Hybrid Queries und mehrstufige Suche
- Qdrant: Hybrid Search mit Re-Ranking
- Weaviate: Hybrid Search
- Weaviate: Vector Indexing
- Milvus: Übersicht der unterstützten Vektorindizes
- Pinecone: Semantic Search
- FAISS: Offizielle Dokumentation
- Microsoft: Hybrid Search in Azure AI Search
- OWASP: Vector and Embedding Weaknesses
Fachlicher Stand: Oktober 2026.