Embedding einfach erklärt
Embeddings gehören zu den wichtigsten Grundlagen moderner Künstlicher Intelligenz. Ohne sie würden viele heutige KI-Anwendungen deutlich schlechter funktionieren oder gar nicht erst möglich sein.
Architektur, Funktionsweise und Bedeutung
Embeddings gehören zu den wichtigsten technischen Grundlagen moderner künstlicher Intelligenz. Sie ermöglichen es, Texte, Bilder und andere Informationen in mathematische Vektoren umzuwandeln, damit Computersysteme inhaltliche Ähnlichkeiten erkennen und vergleichen können.
Ob semantische Suchmaschinen, intelligente Chatbots, Produktempfehlungen oder Retrieval-Augmented Generation (RAG): Embeddings bilden häufig die technische Grundlage, um Informationen nicht nur anhand identischer Wörter, sondern auch anhand ihrer Bedeutung zu finden.
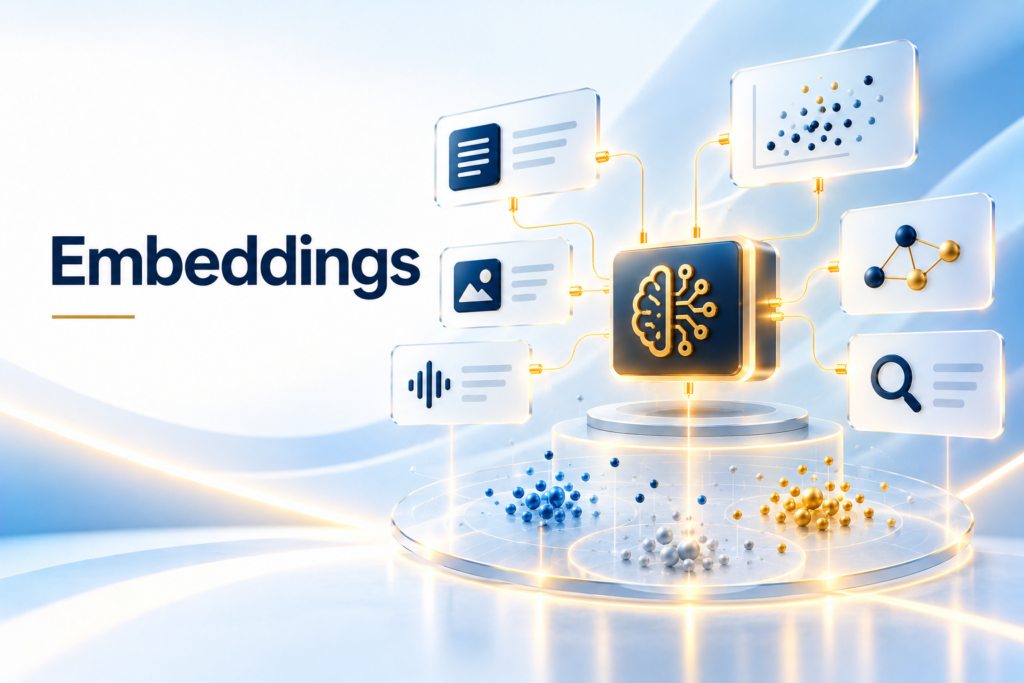
Inzwischen reichen die Einsatzmöglichkeiten weit über die reine Textverarbeitung hinaus. Moderne multimodale Embedding-Modelle können beispielsweise Bilder, gesprochene Sprache, Videos und Dokumente in einem gemeinsamen mathematischen Raum abbilden.
Doch was ist ein Embedding genau? Wie entsteht ein solcher Zahlenvektor, weshalb sind Vektordatenbanken wichtig und welche Rolle spielen Embeddings bei modernen KI-Agenten?
Dieser Ratgeber erklärt die Grundlagen verständlich und zeigt anhand praktischer Beispiele, wie Embeddings funktionieren, wo sie eingesetzt werden und welche Grenzen die Technologie besitzt.
Was sind Embeddings?
Embeddings sind numerische Vektordarstellungen von Informationen, die bestimmte erlernte Merkmale und Beziehungen mathematisch abbilden.
Ein Embedding kann beispielsweise einen Satz, einen Textabschnitt, ein Bild oder einen anderen Inhalt repräsentieren.
Dafür verwendet ein trainiertes KI-Modell eine Folge von Zahlen.
Ein stark vereinfachtes Beispiel:
[0.12, -0.45, 0.88, 0.03, -0.21]
Ein realer Embedding-Vektor besitzt häufig Hunderte oder Tausende solcher Werte.
Jeder Wert ist Teil einer mathematischen Repräsentation. Erst durch die Kombination aller Werte entsteht eine Darstellung, die für weitere Berechnungen verwendet werden kann.
Das Besondere: Ein passend trainiertes Embedding-Modell kann ähnliche Informationen so abbilden, dass ihre Vektoren im gemeinsamen Repräsentationsraum eine hohe Ähnlichkeit aufweisen.
Ein Beispiel:
- „Ich suche eine günstige Ferienwohnung.“
- „Preiswertes Apartment für den Urlaub finden.“
- „Bezahlbare Unterkunft für die Ferien.“
Obwohl die Formulierungen unterschiedlich sind, beschreiben sie eine ähnliche Suchabsicht.
Ein geeignetes Embedding-Modell kann diese semantische Nähe mathematisch erfassen.
Dabei handelt es sich nicht um ein menschliches Verständnis von Bedeutung, sondern um erlernte statistische Beziehungen.
Warum braucht künstliche Intelligenz Embeddings?
Computer arbeiten mit numerischen Daten. Menschliche Sprache besteht dagegen aus Wörtern, Sätzen und Bedeutungszusammenhängen.
Damit moderne KI-Modelle solche Informationen verarbeiten können, benötigen sie geeignete mathematische Darstellungen.
Genau hier kommen Embeddings zum Einsatz.
Ein einfaches Suchsystem könnte beispielsweise nach dem Wort „Auto“ suchen.
Enthält ein Dokument ausschließlich den Begriff „Fahrzeug“, findet eine reine exakte Stichwortsuche möglicherweise keinen Treffer.
Ein semantisches Suchsystem kann dagegen die inhaltliche Nähe zwischen beiden Begriffen berücksichtigen.
Embeddings sind besonders nützlich für:
- Semantische Suche nach inhaltlich verwandten Informationen
- RAG-Systeme und Wissensdatenbanken
- Empfehlungssysteme für Produkte und Inhalte
- Gruppierung ähnlicher Dokumente
- Erkennung thematischer Überschneidungen
- Suche nach ähnlichen Bildern
- Mehrsprachige Dokumentensuche
- Analyse größerer Informationsbestände
Allerdings sind Embeddings nicht für jede KI-Anwendung erforderlich. Auch regelbasierte Systeme, klassische Suchverfahren und andere Machine-Learning-Methoden können ohne spezialisierte semantische Embeddings arbeiten.
Was ist ein Vektorraum?
Ein Vektor ist eine geordnete Liste numerischer Werte.
Ein Embedding-Vektor beschreibt einen Inhalt als Punkt beziehungsweise Richtung in einem mathematischen Raum.
Diesen nennt man Embedding-Raum oder Vektorraum.
Stell dir eine Bibliothek vor, in der Bücher nicht alphabetisch, sondern anhand ihrer inhaltlichen Ähnlichkeit angeordnet werden.
Bücher über Haustiere befinden sich in einem ähnlichen Bereich. Werke über Finanzmärkte oder Maschinenbau liegen möglicherweise in anderen Bereichen.
Ein Embedding-Raum verwendet dafür nicht nur zwei oder drei räumliche Dimensionen, sondern oft mehrere Hundert oder Tausend.
Ein Modell könnte beispielsweise mit 768 oder 1.536 Dimensionen arbeiten.
Die Dimensionen sind dabei keine eindeutig beschrifteten Kategorien wie „Sport“, „Finanzen“ oder „Technologie“.
Informationen sind über zahlreiche mathematische Werte verteilt.
Deshalb lässt sich die Bedeutung eines Embeddings nicht einfach aus einem einzelnen Zahlenwert ablesen.
Auch die räumliche Nähe ist kein perfektes Maß für sachliche Übereinstimmung. Sie beschreibt zunächst nur die vom Modell erlernte Ähnlichkeit.
Wie entstehen Embeddings?
Embeddings werden durch trainierte KI-Modelle erzeugt.
Dabei kommen unterschiedliche Verfahren aus dem Bereich Machine Learning und Deep Learning zum Einsatz.
Für moderne Text-Embeddings werden häufig neuronale Netze und Transformer-basierte Modelle verwendet.
Der grundlegende Ablauf besteht aus mehreren Schritten.
1. Ein Inhalt wird bereitgestellt
Als Eingabe dient beispielsweise folgender Satz:
„Der Kunde sucht ein Elektroauto mit großer Reichweite.“
Das Embedding-Modell erhält diesen Text zur Verarbeitung.
2. Der Text wird tokenisiert
Viele moderne Sprachmodelle zerlegen Texte zunächst in kleinere Einheiten, sogenannte Tokens.
Ein Token kann ein vollständiges Wort, einen Wortbestandteil oder ein anderes Zeichenmuster enthalten.
Jedes Token erhält eine numerische Kennung.
Die anschließende Verarbeitung erfolgt auf Grundlage dieser numerischen Repräsentationen.
3. Das Modell verarbeitet den Kontext
Ein neuronales Netzwerk analysiert die Beziehungen zwischen den Bestandteilen der Eingabe.
Dabei kann es beispielsweise erlernte Zusammenhänge zwischen Elektroautos, Reichweite und Kaufabsicht berücksichtigen.
Moderne Transformer-Modelle verwenden hierfür unter anderem Attention-Mechanismen.
4. Das Modell erzeugt eine Vektordarstellung
Aus der Verarbeitung entsteht ein Embedding.
Bei einem Text-Embedding repräsentiert dieser Vektor die vom Modell erfassten Eigenschaften der gesamten Eingabe.
Das Verfahren zur Erzeugung eines einzelnen Satz- oder Dokumentvektors hängt von der jeweiligen Modellarchitektur ab.
5. Der Vektor wird verwendet
Das System kann den erzeugten Vektor speichern, mit anderen Vektoren vergleichen oder für weitere Aufgaben nutzen.
Auf diese Weise lassen sich beispielsweise ähnliche Dokumente finden.
Wichtig ist: Das Embedding selbst enthält keine fertige Antwort auf eine Frage. Es ist eine mathematische Repräsentation, die andere Verfahren zur Informationssuche oder Analyse verwenden können.
Welche Arten von Embeddings gibt es?
Embeddings können unterschiedliche Informationsarten und Verarbeitungsebenen repräsentieren.
| Embedding-Art | Typische Anwendung |
|---|---|
| Token-Embeddings | Numerische Darstellung einzelner Tokens |
| Wort-Embeddings | Beziehungen zwischen Wörtern |
| Satz-Embeddings | Semantischer Vergleich vollständiger Sätze |
| Dokument-Embeddings | Ähnlichkeitssuche in Textbeständen |
| Bild-Embeddings | Vergleich visueller Inhalte |
| Audio-Embeddings | Suche und Analyse akustischer Informationen |
| Multimodale Embeddings | Gemeinsamer Vergleich unterschiedlicher Medienarten |
Wort-Embeddings
Frühere Verfahren wie Word2Vec und GloVe erzeugten numerische Darstellungen einzelner Wörter.
Dadurch ließen sich semantische Beziehungen mathematisch erfassen.
Ein Nachteil klassischer statischer Wort-Embeddings ist, dass ein Wort unabhängig von seinem konkreten Satzkontext häufig dieselbe Repräsentation erhält.
Kontextuelle Embeddings
Moderne Sprachmodelle können die Bedeutung eines Wortes anhand seiner Umgebung berücksichtigen.
Ein bekanntes Beispiel ist das Wort „Bank“.
In den Sätzen „Ich gehe zur Bank“ und „Ich sitze auf der Bank im Park“ beschreibt es unterschiedliche Dinge.
Kontextabhängige Repräsentationen können diesen Unterschied abbilden.
Satz-Embeddings
Satz-Embeddings verdichten die Informationen eines ganzen Satzes zu einem Vektor.
Sie eignen sich beispielsweise für die Suche nach ähnlichen Fragen oder die Erkennung inhaltlich verwandter Formulierungen.
Dokument-Embeddings
Dokument-Embeddings repräsentieren längere Texte.
Bei umfangreichen Dokumenten ist es allerdings häufig sinnvoll, diese zunächst in kleinere Abschnitte zu unterteilen.
Dadurch können einzelne Aussagen gezielter gefunden werden.
Multimodale Embeddings
Multimodale Embeddings ermöglichen die gemeinsame Verarbeitung unterschiedlicher Informationsarten.
Ein geeignetes Modell kann beispielsweise eine Bildbeschreibung und ein dazu passendes Foto mathematisch miteinander vergleichen.
Diese Fähigkeit wird bei modernen multimodalen KI-Systemen zunehmend wichtiger.
Embeddings und Transformer: Was ist der Zusammenhang?
Die Transformer-Architektur ist eine wichtige technische Grundlage moderner Sprachmodelle.
Transformer benötigen numerische Repräsentationen ihrer Eingaben.
Dazu werden Tokens in Vektoren umgewandelt und innerhalb des Netzwerks weiterverarbeitet.
Während dieser Verarbeitung entstehen kontextabhängige interne Repräsentationen.
Es ist allerdings wichtig, zwischen zwei verschiedenen Verwendungen des Begriffs Embedding zu unterscheiden.
Interne Token-Embeddings sind Bestandteile der Modellverarbeitung.
Semantische Text-Embeddings werden dagegen häufig durch spezialisierte Modelle erzeugt, die für Ähnlichkeitssuche, Klassifikation oder Informationsabruf optimiert wurden.
Nicht jeder beliebige interne Transformer-Vektor eignet sich automatisch für eine hochwertige semantische Suche.
Dafür werden häufig speziell trainierte Embedding-Modelle eingesetzt.
Wie große Sprachmodelle insgesamt aufgebaut sind, erklärt der Artikel über Large Language Models.
Wie misst man die Ähnlichkeit zwischen Embeddings?
Sobald zwei Inhalte als Vektoren dargestellt sind, lässt sich ihre mathematische Ähnlichkeit berechnen.
Dafür existieren verschiedene Verfahren.
Besonders verbreitet ist die sogenannte Kosinus-Ähnlichkeit (Cosine Similarity).
Kosinus-Ähnlichkeit
Die Kosinus-Ähnlichkeit vergleicht die Richtung zweier Vektoren.
Bei nicht nullwertigen Vektoren liegt der mathematische Wert zwischen −1 und +1.
Ein Wert nahe +1 bedeutet, dass die Vektoren in eine ähnliche Richtung zeigen.
Ein Wert nahe 0 beschreibt eine geringe Richtungsübereinstimmung.
Ein Wert nahe −1 bedeutet, dass die Vektoren in entgegengesetzte Richtungen zeigen.
Diese Interpretation gilt für die Vektoren, nicht unmittelbar für die tatsächliche fachliche Bedeutung der Texte.
Eine Kosinus-Ähnlichkeit von 0,90 bedeutet deshalb nicht, dass zwei Dokumente zu 90 Prozent dasselbe aussagen.
Weitere Ähnlichkeitsmaße
Neben der Kosinus-Ähnlichkeit werden unter anderem das Skalarprodukt und die euklidische Distanz verwendet.
Welches Verfahren geeignet ist, hängt vom Modell und der jeweiligen Anwendung ab.
Einige Embedding-Modelle erzeugen normalisierte Vektoren. Dadurch können bestimmte Ähnlichkeitsmaße dieselbe Trefferreihenfolge ergeben.
Die konkreten Empfehlungen sollten der Dokumentation des verwendeten Modells entnommen werden.
Was unterscheidet semantische Suche von Keyword-Suche?
Die klassische Keyword-Suche und die semantische Suche verfolgen unterschiedliche Ansätze.
Eine Keyword-Suche bewertet vor allem, welche Wörter oder Zeichenfolgen innerhalb eines Dokuments vorkommen.
Eine semantische Suche verwendet dagegen mathematische Repräsentationen, um auch inhaltlich verwandte Formulierungen zu erkennen.
| Eigenschaft | Keyword-Suche | Embedding-Suche |
|---|---|---|
| Exakte Begriffe | Besonders geeignet | Nicht immer zuverlässig |
| Synonyme | Abhängig vom Suchverfahren | Häufig gut erkennbar |
| Produktnummern | Sehr gut geeignet | Teilweise problematisch |
| Natürliche Fragen | Unterschiedlich leistungsfähig | Häufig vorteilhaft |
| Semantische Ähnlichkeit | Eingeschränkt | Zentrale Stärke |
| Rechenaufwand | Abhängig vom Index | Zusätzliche Modellberechnung |
Ein Beispiel:
Ein Besucher sucht nach „günstige Ferienwohnung mit Pool“.
Ein Dokument könnte stattdessen die Formulierung „preiswertes Apartment mit Gemeinschaftsschwimmbad“ verwenden.
Ein geeignetes Embedding-Modell kann erkennen, dass beide Beschreibungen inhaltlich verwandt sind.
Eine reine exakte Stichwortsuche könnte dagegen wichtige Treffer übersehen.
Umgekehrt ist die klassische Suche oft überlegen, wenn ein Nutzer nach einer bestimmten Modellnummer, einem Gesetzesparagraphen oder einer eindeutigen Produktbezeichnung sucht.
Warum ist Hybrid Search häufig die bessere Lösung?
Moderne Suchsysteme kombinieren deshalb zunehmend unterschiedliche Suchverfahren.
Diese Kombination wird als Hybrid Search bezeichnet.
Typischerweise werden dabei Keyword-Suche und semantische Vektorsuche miteinander verbunden.
Beispielsweise kann ein System zunächst passende Ergebnisse aus beiden Suchverfahren sammeln.
Anschließend werden die Trefferlisten zusammengeführt oder neu gewichtet.
Ein bekanntes Verfahren dafür ist Reciprocal Rank Fusion (RRF).
Hybrid Search bietet insbesondere Vorteile, wenn sowohl exakte Fachbegriffe als auch semantische Bedeutungen wichtig sind.
Bei einer Wissensdatenbank können auf diese Weise konkrete Produktnamen zuverlässig gefunden werden, während gleichzeitig sinngemäße Fragen berücksichtigt werden.
Hybrid Search ist jedoch nicht grundsätzlich bei jeder Aufgabe überlegen.
Die tatsächliche Qualität muss anhand realistischer Suchanfragen überprüft werden.
Welche Rolle spielen Embeddings bei RAG?
Retrieval-Augmented Generation (RAG) kombiniert ein generatives Sprachmodell mit externen Informationsquellen.
Anstatt ausschließlich auf im Training erlernte Informationen zurückzugreifen, kann das System relevante Inhalte aus Dokumenten oder Datenbanken abrufen.
Embeddings werden dafür häufig eingesetzt.
Ein typischer Ablauf sieht folgendermaßen aus.
1. Dokumente vorbereiten
Eine Wissensdatenbank enthält beispielsweise Bedienungsanleitungen, Produktinformationen oder Fachartikel.
Diese Dokumente werden eingelesen und in geeignete Abschnitte unterteilt.
2. Embeddings erzeugen
Für die Textabschnitte werden numerische Embeddings berechnet.
Diese können gemeinsam mit den zugehörigen Texten und Metadaten gespeichert werden.
3. Nutzerfrage verarbeiten
Stellt ein Nutzer eine Frage, wird diese mit einem kompatiblen Embedding-Verfahren ebenfalls numerisch dargestellt.
4. Relevante Inhalte suchen
Das System vergleicht den Anfragevektor mit den gespeicherten Vektoren.
Die relevantesten Treffer werden ausgewählt.
5. Ergebnisse an das Sprachmodell übergeben
Das Large Language Model erhält die gefundenen Informationen als zusätzlichen Kontext.
Damit kann es eine Antwort auf Grundlage der bereitgestellten Dokumente erzeugen.
Die Architektur erklären wir ausführlich im Artikel über Retrieval-Augmented Generation.
Wichtig: RAG ist nicht zwingend auf Embeddings beschränkt.
Auch klassische Textsuche, strukturierte Datenbankabfragen oder kombinierte Retrieval-Verfahren können Bestandteil eines RAG-Systems sein.
Embeddings sind somit ein sehr verbreiteter, aber kein zwingend erforderlicher Bestandteil.
Ebenso garantiert RAG keine fehlerfreien Antworten. Ungeeignete Suchtreffer oder falsch interpretierte Dokumente können weiterhin zu Halluzinationen führen.
Was sind Chunks und warum sind sie wichtig?
Bei umfangreichen Dokumenten werden häufig nicht vollständige Dateien als einzelne Embeddings gespeichert.
Stattdessen werden Dokumente in kleinere Abschnitte unterteilt.
Diese Abschnitte bezeichnet man als Chunks.
Ein Chunk kann beispielsweise einen Absatz, mehrere zusammenhängende Textstellen oder einen vollständigen Unterabschnitt enthalten.
Zu kleine Chunks
Sehr kurze Abschnitte können wichtige Zusammenhänge verlieren.
Eine einzelne Aussage ist möglicherweise nur zusammen mit den vorangehenden Sätzen verständlich.
Zu große Chunks
Sehr umfangreiche Abschnitte können mehrere unterschiedliche Themen enthalten.
Dadurch wird die semantische Suche möglicherweise unpräziser.
Außerdem erhöhen lange Suchtreffer den späteren Kontextverbrauch eines Sprachmodells.
Chunk Overlap
Bei manchen Verfahren überlappen benachbarte Chunks teilweise.
Dadurch können zusammenhängende Informationen über Abschnittsgrenzen hinweg besser erhalten bleiben.
Die optimale Chunkgröße hängt vom Dokumenttyp, den Anforderungen und dem verwendeten Modell ab.
Eine pauschal ideale Anzahl von Tokens pro Chunk existiert nicht.
Was sind Vektordatenbanken?
Wenn viele Embeddings gespeichert und durchsucht werden sollen, benötigt man eine geeignete Datenstruktur.
Dafür werden häufig Vektordatenbanken verwendet.
Eine Vektordatenbank kann numerische Vektoren speichern und ähnliche Einträge effizient finden.
Für größere Datenbestände werden häufig spezialisierte Indexverfahren eingesetzt.
Dazu gehören beispielsweise HNSW und andere Verfahren zur Approximate Nearest Neighbor Search.
Diese ermöglichen eine schnellere Suche, indem sie unter bestimmten Bedingungen einen kleinen Genauigkeitsverlust gegenüber einer vollständigen exakten Suche akzeptieren.
Nicht jedes Projekt benötigt dafür ein eigenständiges Vektordatenbanksystem.
Auch klassische Datenbankplattformen können entsprechende Erweiterungen verwenden.
Ein Beispiel ist PostgreSQL mit der Erweiterung pgvector.
Damit lassen sich Vektoren und andere strukturierte Daten in derselben Datenbank verwalten.
Die unterschiedlichen Möglichkeiten erklären wir unter Vektordatenbanken einfach erklärt.
Multimodale Embeddings: Die Entwicklung 2026
Eine bedeutende Weiterentwicklung sind Embedding-Modelle, die mehrere Medienarten gemeinsam verarbeiten können.
Frühere Anwendungen verwendeten häufig getrennte Modelle für Text und Bilder.
Moderne multimodale Modelle können dagegen unterschiedliche Inhalte in einem gemeinsamen Repräsentationsraum abbilden.
Ein Beispiel ist Gemini Embedding 2 von Google, dessen allgemeine Verfügbarkeit im April 2026 bekannt gegeben wurde.
Das Modell kann verschiedene Eingabearten wie Text, Bilder, Audio, Video und PDF-Dokumente verarbeiten.
Dadurch entstehen neue Möglichkeiten für medienübergreifende Suchsysteme.
Text-zu-Bild-Suche
Ein Nutzer formuliert eine Anfrage wie:
„Zeige Fotos von Motorrädern auf einer kurvenreichen Küstenstraße.“
Ein geeignetes multimodales Modell kann diese Textbeschreibung mit gespeicherten Bild-Embeddings vergleichen.
Dadurch lassen sich passende Fotos finden, auch wenn sie keine entsprechenden Dateinamen oder Schlagwörter besitzen.
Audio- und Videosuche
Auch Audioaufnahmen und Videoinhalte können durch geeignete Modelle in mathematische Repräsentationen überführt werden.
Dadurch lassen sich Medieninhalte thematisch durchsuchen.
Die Qualität hängt allerdings von den verarbeiteten Informationen, der zeitlichen Auflösung und den Modellfähigkeiten ab.
Ein Video-Embedding enthält nicht zwangsläufig sämtliche Details jeder einzelnen Szene.
Dokumente mit Bildern und Text
Besonders interessant sind multimodale Embeddings bei PDFs, Präsentationen und technischen Dokumentationen.
Ein Dokument kann wichtige Informationen sowohl in Textabschnitten als auch in Tabellen oder Abbildungen enthalten.
Ein multimodales Retrieval-System kann diese unterschiedlichen Informationstypen bei der Suche berücksichtigen.
Allerdings funktioniert eine gemeinsame medienübergreifende Suche nur, wenn die Repräsentationen durch kompatible beziehungsweise entsprechend gemeinsam trainierte Modelle erzeugt wurden.
Was bedeutet mehrsprachiges Embedding?
Mehrsprachige Embedding-Modelle ermöglichen es, Inhalte unterschiedlicher Sprachen semantisch miteinander zu vergleichen.
Ein Beispiel:
Die Anfrage lautet auf Deutsch:
„Wie kann ich meine Stromkosten reduzieren?“
Die Wissensdatenbank enthält dagegen einen englischen Artikel über „reducing electricity expenses“.
Ein geeignetes mehrsprachiges Modell kann die inhaltliche Beziehung zwischen beiden Texten erkennen.
Dadurch entstehen Möglichkeiten für internationale Wissensdatenbanken und mehrsprachige Suchanwendungen.
Das bedeutet jedoch nicht, dass jedes Embedding-Modell alle Sprachen gleich zuverlässig verarbeitet.
Besonders Fachbegriffe, regionale Ausdrucksweisen und unterschiedliche Schreibsysteme können die Qualität beeinflussen.
Für deutschsprachige Anwendungen sollten daher geeignete Tests mit deutschen Texten und realistischen Suchanfragen durchgeführt werden.
Wie wählt man ein gutes Embedding-Modell aus?
Embedding-Modelle unterscheiden sich in Leistungsfähigkeit, Sprachunterstützung, Kosten und technischen Eigenschaften.
Die Auswahl sollte deshalb nicht ausschließlich anhand eines bekannten Modellnamens erfolgen.
Wichtige Kriterien sind:
| Kriterium | Bedeutung |
|---|---|
| Retrieval-Qualität | Wie zuverlässig relevante Treffer gefunden werden |
| Sprachunterstützung | Eignung für Deutsch und weitere Sprachen |
| Fachgebiet | Qualität bei speziellen Themen oder Fachbegriffen |
| Vektordimensionen | Einfluss auf Speicherbedarf und Verarbeitung |
| Eingabelänge | Maximale Text- beziehungsweise Dokumentlänge |
| Geschwindigkeit | Dauer der Embedding-Berechnung |
| Kosten | API-Gebühren oder lokale Betriebskosten |
| Datenschutz | Verarbeitung und Speicherung der Eingabedaten |
| Lizenz | Zulässigkeit der geplanten Nutzung |
Welche Rolle spielen Benchmarks?
Ein bekannter Bewertungsansatz ist der Massive Text Embedding Benchmark (MTEB).
Er umfasst unterschiedliche Aufgaben wie Retrieval, Klassifikation, Clustering und semantische Textähnlichkeit.
Die MTEB-Projekte wurden 2026 weiterentwickelt und bieten umfangreiche Vergleichsmöglichkeiten für unterschiedliche Sprachen und Modellarten.
Öffentliche Benchmarks sind hilfreich, aber sie ersetzen keine eigenen Tests.
Ein Modell, das bei englischen Standardaufgaben sehr gute Ergebnisse erzielt, muss nicht zwingend die beste Wahl für eine deutschsprachige Fachwebsite sein.
Besonders wichtig ist daher die Qualität bei den tatsächlichen Suchanfragen und Inhalten des eigenen Projekts.
Was bedeuten die Dimensionen eines Embeddings?
Die Dimension beschreibt die Anzahl numerischer Werte eines Vektors.
Ein Embedding mit 768 Dimensionen enthält beispielsweise 768 Zahlenwerte.
Ein Vektor mit 1.536 Dimensionen enthält entsprechend 1.536 Werte.
Mehr Dimensionen bedeuten allerdings nicht automatisch eine bessere semantische Repräsentation.
Die Qualität hängt auch vom Trainingsverfahren, der Modellarchitektur und der jeweiligen Aufgabe ab.
Einige moderne Embedding-Modelle unterstützen unterschiedliche Ausgabegrößen.
Damit lässt sich unter Umständen ein Kompromiss zwischen Speicherbedarf und Suchqualität erreichen.
Wie viel Speicher benötigen Embeddings?
Bei der Speicherung von Vektoren spielt die Anzahl der Dimensionen eine wichtige Rolle.
Ein stark vereinfachtes Beispiel:
Ein Embedding besitzt 1.536 Dimensionen.
Jeder Wert wird als 32-Bit-Gleitkommazahl gespeichert und benötigt vier Byte.
Daraus ergibt sich:
1.536 × 4 Byte = 6.144 Byte pro Embedding
Bei 100.000 solcher Embeddings wären dies ungefähr 614 MB allein für die Rohdaten der Vektoren.
Zusätzlicher Speicher wird unter anderem für Texte, Metadaten, Indizes und Datenbankverwaltung benötigt.
Bei größeren Wissensbeständen lohnt es sich daher, die Vektordimensionen und Speicherformate sorgfältig auszuwählen.
Warum kann man Embeddings nicht beliebig austauschen?
Ein wichtiger technischer Punkt wird häufig übersehen:
Vektoren unterschiedlicher Embedding-Modelle sind nicht automatisch miteinander vergleichbar.
Jedes Modell erlernt seinen eigenen mathematischen Repräsentationsraum.
Selbst wenn zwei Modelle dieselbe Vektorgröße erzeugen, können die einzelnen Zahlen völlig unterschiedliche Bedeutungsstrukturen repräsentieren.
Ein Text-Embedding des Modells A sollte deshalb nicht ohne Weiteres mit einem Dokument-Embedding des Modells B verglichen werden.
Bei einem Modellwechsel ist häufig eine erneute Indexierung vorhandener Dokumente erforderlich.
Auch Änderungen an der Modellversion oder der Vektordimension können Einfluss auf gespeicherte Suchindizes haben.
Für stabile Produktivsysteme sollten deshalb Modellversion, Dimension und Indexierungsverfahren dokumentiert werden.
Was ist Re-Ranking?
Ein Suchsystem muss nicht zwangsläufig seine endgültige Trefferliste ausschließlich anhand von Embedding-Ähnlichkeiten bestimmen.
Häufig wird zunächst eine größere Menge möglicher Treffer gesucht.
Danach bewertet ein weiteres Modell diese Ergebnisse genauer.
Dieses Verfahren bezeichnet man als Re-Ranking.
Beispielsweise könnte eine Vektorsuche zunächst 30 mögliche Dokumentabschnitte finden.
Ein Re-Ranker untersucht anschließend die Beziehung zwischen Nutzerfrage und einzelnen Treffern genauer.
Danach werden die besten Abschnitte für die eigentliche Antwort ausgewählt.
Solche Verfahren können die Suchqualität verbessern.
Sie verursachen allerdings zusätzlichen Rechenaufwand und möglicherweise zusätzliche Kosten.
Re-Ranking ist besonders interessant, wenn die fachliche Genauigkeit wichtiger ist als die geringstmögliche Bearbeitungszeit.
Sind Embeddings datenschutzrechtlich unbedenklich?
Embeddings wirken auf den ersten Blick anonym, weil sie nur aus Zahlen bestehen.
Doch diese Annahme ist problematisch.
Ein Embedding ist nicht automatisch anonym oder datenschutzrechtlich unbedenklich.
Wissenschaftliche Untersuchungen zeigen, dass unter bestimmten Bedingungen Informationen über die ursprünglichen Texte aus Embeddings rekonstruiert beziehungsweise abgeleitet werden können.
Solche Verfahren werden als Embedding Inversion Attacks bezeichnet.
Eine 2024 veröffentlichte ACL-Studie untersuchte entsprechende Angriffe auf Text-Embeddings.
Auch Forschungsarbeiten aus dem Jahr 2026 behandeln die gezielte Reduzierung solcher Datenschutzrisiken.
Für Unternehmen bedeutet das:
- Personenbezogene Daten sollten nicht ungeprüft in externe Embedding-Dienste übertragen werden.
- Vektordatenbanken benötigen geeignete Zugriffskontrollen.
- Vertrauliche Inhalte sollten nur für autorisierte Benutzer abrufbar sein.
- Speicher- und Löschregeln müssen auch Embeddings berücksichtigen.
- Sensible Informationen sollten nach Möglichkeit vor der Verarbeitung minimiert werden.
Die konkreten Anforderungen hängen von der tatsächlichen Datenverarbeitung und den geltenden Datenschutzvorschriften ab.
Ein lokales Embedding-Modell kann die externe Datenübertragung reduzieren, ersetzt aber keine technische oder rechtliche Sicherheitsprüfung.
Welche Grenzen haben Embeddings?
Embeddings sind leistungsfähig, aber nicht für jede Aufgabe gleichermaßen zuverlässig.
Semantische Nähe ist keine Faktenprüfung
Zwei Texte können thematisch ähnlich sein und trotzdem unterschiedliche oder widersprüchliche Aussagen enthalten.
Ein Embedding-Modell bewertet nicht automatisch die Wahrheit einer Behauptung.
Zahlen und Kennungen können problematisch sein
Bestimmte Produktnummern, genaue Datumsangaben oder rechtliche Fundstellen lassen sich mit einer klassischen Suche häufig zuverlässiger finden.
Schlechte Chunks verschlechtern die Suche
Wenn wichtige Informationen durch eine unpassende Dokumentaufteilung getrennt werden, kann selbst ein gutes Embedding-Modell unzureichende Ergebnisse liefern.
Fachsprache erfordert geeignete Modelle
Spezialisierte Begriffe aus Medizin, Recht oder Technik werden nicht von jedem Modell gleich zuverlässig abgebildet.
Mehrsprachigkeit muss getestet werden
Ein Modell kann bei englischen Aufgaben hervorragend funktionieren, aber bei bestimmten deutschen Fachtexten schwächer abschneiden.
Datenschutz bleibt relevant
Auch numerische Vektoren können sensible Informationen enthalten oder indirekt offenlegen.
Eine fachlich zuverlässige Anwendung muss diese Grenzen bei der Entwicklung berücksichtigen.
Embeddings in der Praxis: Ein Wissensportal verbessern
Für ein umfangreiches KI-Wissensportal können Embeddings besonders interessant sein.
Angenommen, eine Website enthält Hunderte oder Tausende Fachartikel über künstliche Intelligenz.
Ein Besucher möchte wissen, welche Unterschiede zwischen klassischen Sprachmodellen und KI-Agenten bestehen.
Anstatt ausschließlich nach den exakten Wörtern zu suchen, könnte ein semantisches Suchsystem relevante Textabschnitte aus mehreren Artikeln finden.
Dafür werden die Inhalte zuvor in geeignete Abschnitte unterteilt und eingebettet.
Bei der Suchanfrage werden passende Informationen anhand ihrer mathematischen Ähnlichkeit ermittelt.
Intelligente Website-Suche
Besucher können Fragen in natürlicher Sprache stellen, ohne die exakten Fachbegriffe zu kennen.
Thematisch verwandte Artikel
Ein System kann Inhalte erkennen, die ein ähnliches Themengebiet behandeln.
Daraus können Vorschläge für passende weiterführende Beiträge entstehen.
Erkennung ähnlicher Inhalte
Embeddings helfen dabei, inhaltlich verwandte oder möglicherweise stark überschneidende Artikel zu identifizieren.
Das kann bei der redaktionellen Qualitätskontrolle unterstützen.
Automatische Themencluster
Eine größere Artikelsammlung lässt sich mithilfe von Clustering-Verfahren in thematische Gruppen ordnen.
Dadurch können Redakteure Lücken und Überschneidungen im Content-Angebot erkennen.
KI-gestützter Wissensassistent
Ein Chatbot kann über ein Retrieval-System passende Informationen aus veröffentlichten Artikeln abrufen und Antworten darauf aufbauen.
Die Antworten sollten nachvollziehbare Quellenangaben enthalten.
Für die Suchmaschinenoptimierung gilt allerdings: Embeddings sind kein direkter Rankingfaktor, der allein durch ihren Einsatz bessere Google-Positionen garantiert.
Ihr praktischer Nutzen liegt vor allem in besserer Informationserschließung, Navigation und Inhaltsorganisation.
Muss man Embedding-Modelle selbst trainieren?
Für die meisten Projekte ist das nicht erforderlich.
Es existieren zahlreiche vortrainierte Embedding-Modelle, die für allgemeine oder spezialisierte Aufgaben verwendet werden können.
Ein neues Projekt sollte zunächst ein geeignetes vorhandenes Modell auswählen und anhand realistischer Aufgaben testen.
Eine eigene Anpassung kann sinnvoll sein, wenn bestimmte Fachbegriffe, Sprachen oder Dokumenttypen besonders wichtig sind.
Dafür kommen gegebenenfalls Verfahren aus dem Bereich Fine-Tuning zum Einsatz.
Vor einer solchen Anpassung sollte jedoch geprüft werden, ob Verbesserungen durch bessere Dokumentaufteilung, Hybrid Search oder Re-Ranking bereits ausreichen.
Welche Kosten entstehen bei Embeddings?
Die Kosten hängen davon ab, ob ein Embedding-Modell über eine externe API oder lokal betrieben wird.
Bei API-Diensten kann die Abrechnung beispielsweise anhand der verarbeiteten Eingabe-Tokens erfolgen.
Hinzu kommen möglicherweise Kosten für Speicherung, Suchabfragen und weitere Verarbeitungsschritte.
Bei lokal betriebenen Modellen entstehen dagegen vor allem Hardware-, Energie- und Wartungskosten.
Für größere Projekte ist zusätzlich wichtig, wie häufig Dokumente neu eingebettet werden müssen.
Wenn sich eine Wissensdatenbank täglich verändert, können regelmäßig neue Embeddings erforderlich sein.
Ein effizienter Aufbau sollte deshalb unveränderte Inhalte nicht unnötig erneut verarbeiten.
Wie bewertet man die Qualität einer Embedding-Suche?
Ein Suchsystem sollte nicht allein anhand einzelner überzeugender Beispiele beurteilt werden.
Für eine zuverlässige Bewertung empfiehlt sich ein Testdatensatz mit realistischen Fragen und passenden Referenzdokumenten.
Wichtige Kennzahlen sind beispielsweise:
Recall@k: Wie viele relevante Treffer befinden sich unter den ersten k Suchergebnissen?
Precision@k: Wie groß ist der Anteil relevanter Ergebnisse unter den ersten k Treffern?
MRR (Mean Reciprocal Rank): Wie weit oben erscheint der erste relevante Treffer?
nDCG: Wie gut entspricht die Rangfolge der Ergebnisse einer abgestuften Relevanzbewertung?
Solche Kennzahlen helfen dabei, verschiedene Embedding-Modelle und Suchstrategien nachvollziehbar zu vergleichen.
Dabei sollte insbesondere getestet werden, ob das System die benötigten Informationen tatsächlich findet.
Ein guter Ähnlichkeitswert allein ist noch kein Beweis für ein gutes Suchergebnis.
Häufig gestellte Fragen zu Embeddings
Was sind Embeddings einfach erklärt?
Embeddings sind numerische Vektordarstellungen von Informationen. Sie ermöglichen es KI-Systemen, mathematische Beziehungen und semantische Ähnlichkeiten zwischen Texten, Bildern oder anderen Inhalten zu vergleichen.
Was ist der Unterschied zwischen einem Token und einem Embedding?
Ein Token ist eine Verarbeitungseinheit, beispielsweise ein Wortbestandteil. Ein Embedding ist eine numerische Repräsentation eines Tokens oder eines größeren Inhalts. Beide Konzepte erfüllen unterschiedliche Aufgaben innerhalb moderner KI-Systeme.
Wie viele Dimensionen hat ein Embedding?
Die Anzahl der Dimensionen hängt vom jeweiligen Modell ab. Häufig werden Hunderte oder Tausende Werte verwendet. Einige moderne Modelle unterstützen unterschiedliche Ausgabegrößen.
Wofür werden Embeddings bei RAG verwendet?
Sie helfen dabei, Nutzerfragen mit gespeicherten Dokumentabschnitten semantisch zu vergleichen. Relevante Treffer können anschließend als zusätzlicher Kontext für ein Sprachmodell verwendet werden.
Benötigt jedes RAG-System Embeddings?
Nein. RAG kann auch klassische Suchverfahren oder strukturierte Datenbankabfragen verwenden. Embeddings sind besonders verbreitet, wenn semantische Ähnlichkeit gesucht wird.
Sind Embeddings dasselbe wie eine Vektordatenbank?
Nein. Ein Embedding ist eine numerische Darstellung. Eine Vektordatenbank ist ein System zur Speicherung und effizienten Suche solcher Darstellungen.
Können Embeddings Bilder verstehen?
Geeignet trainierte Modelle können Bilder in numerische Repräsentationen umwandeln, die visuelle oder semantische Eigenschaften abbilden. Das entspricht jedoch nicht einem menschlichen Bildverständnis.
Können Embeddings unterschiedliche Sprachen vergleichen?
Ja. Mehrsprachige Embedding-Modelle können semantische Beziehungen zwischen Texten unterschiedlicher Sprachen erfassen. Wie zuverlässig das funktioniert, hängt vom Modell und den jeweiligen Sprachen ab.
Sind Embeddings anonym?
Nicht automatisch. Unter bestimmten Bedingungen können Informationen aus Embeddings rekonstruiert oder abgeleitet werden. Deshalb sind geeignete Datenschutz- und Sicherheitsmaßnahmen erforderlich.
Was ist der Unterschied zwischen Embeddings und einem LLM?
Ein Large Language Model verarbeitet Sprache und kann beispielsweise Texte generieren. Ein spezialisiertes Embedding-Modell erzeugt dagegen Vektoren, die insbesondere für Ähnlichkeitsvergleiche und weitere Analyseaufgaben verwendet werden.
Können Embeddings Halluzinationen verhindern?
Nein. Sie können helfen, relevante Informationen für RAG-Systeme bereitzustellen. Die spätere Antwort eines Sprachmodells kann dennoch falsche oder unbegründete Aussagen enthalten.
Können Embeddings für SEO verwendet werden?
Sie können bei der Gruppierung ähnlicher Inhalte, der Erkennung thematischer Überschneidungen und der Verbesserung interner Suchfunktionen helfen. Ein direkter Rankingvorteil durch die bloße Verwendung von Embeddings ist daraus nicht abzuleiten.
Fazit: Embeddings als Grundlage moderner KI-Suche
Embeddings gehören zu den zentralen Technologien moderner künstlicher Intelligenz.
Sie wandeln Informationen in numerische Vektoren um und ermöglichen es Computersystemen, mathematische Ähnlichkeiten zwischen Inhalten zu erkennen.
Besonders wichtig sind sie für semantische Suche, Empfehlungssysteme, Dokumentenanalyse und zahlreiche RAG-Anwendungen.
Durch moderne multimodale Modelle lassen sich inzwischen auch unterschiedliche Medienarten in gemeinsamen mathematischen Repräsentationsräumen vergleichen.
Dabei bleiben technische Einschränkungen bestehen.
Semantische Ähnlichkeit garantiert keine faktische Richtigkeit. Unterschiedliche Embedding-Modelle sind nicht automatisch kompatibel, und numerische Vektoren sind nicht grundsätzlich anonym.
Für professionelle Anwendungen kommt es deshalb auf die richtige Kombination aus Modellqualität, Datenaufbereitung, Suchverfahren und Sicherheit an.
Embeddings machen Informationen mathematisch vergleichbar. Ob daraus eine zuverlässige KI-Anwendung entsteht, hängt von der gesamten technischen Architektur ab.
Weiterführendes KI-Wissen
Diese Grundlagenartikel auf KIRatgeber erläutern die Technologien, die mit Embeddings zusammenhängen:
- Vektordatenbanken: Speicherung und Ähnlichkeitssuche
- Retrieval-Augmented Generation: RAG verstehen
- Transformer-Architektur: Verarbeitung von Informationen
- Large Language Models: Wie Sprachmodelle funktionieren
- Machine Learning und Deep Learning erklärt
- KI-Modelle: Aufbau und Funktionsweise
- Fine-Tuning: KI-Modelle gezielt anpassen
- Prompt Engineering: KI-Anweisungen gestalten
- KI-Glossar: Wichtige Fachbegriffe
Quellen und technische Dokumentationen
Die folgenden Quellen bieten zusätzliche technische Grundlagen und weiterführende Informationen:
- OpenAI: Vector Embeddings und semantische Suche
- Google AI: Embeddings und multimodale Modelle
- Google: Gemini Embedding 2 – Allgemeine Verfügbarkeit 2026
- Sentence Transformers: Semantic Search
- MTEB: Benchmark zur Bewertung von Embedding-Modellen
- pgvector: Vektorähnlichkeitssuche mit PostgreSQL
- ACL 2024: Datenschutzrisiken durch Embedding Inversion
- ICLR 2026: Privacy Mechanisms for Embedding Inversion Attacks
Fachlicher Stand: Oktober 2026.